AI 阅读声明:这里使用了AI进行辅助理解某些个人缺失的知识和技术点,有些地方可能存在错误
Reference
- Test-Time Training with Self-Supervision for Generalization under Distribution Shifts
- Learning to (Learn at Test Time): RNNs with Expressive Hidden States
- Test-Time Training Done Right(LaCT)
- End-to-End Test-Time Training for Long Context(TTT-E2E)
- 平均之路:从Attention到TTT — 苏剑林
- RoboTTT: Context Scaling for Robot Policies
- T²Mem: Learning Test-Time Memory for Robotics
Original
Test-Time Training with Self-Supervision for Generalization under Distribution Shifts 2019
Test Time Training,不考虑某知名学者的话,这是正式提出TTT的工作,第一作者是YuSun
Motivation:
希望解决OOD泛化的问题,监督学习缺少OOD能力,对抗等方式预先设计(预测)了符合任务要求的扰动来适应test time distribution
如果既没有合适的扰动模型,也没有数据分布,怎么实现OOD泛化
认为测试时的数据提供了测试分布的hint,希望在测试时先根据数据更新参数本身,然后再进行预测,核心难点在于怎么设计 测试时数据和参数更新的反馈
Methods
此时TTT的做法是,对于一模型,加入一个自监督的辅助损失和对应的预测头
此时会得到一个Y型的模型架构,其中 部分是共享的, 分别是主任务(main loss)和自监督/TTT各自独立的参数
训练时更新
推理时更新
具体而言,这里选用的自监督任务是 图片旋转90的倍数,要求模型判断施加了哪种旋转
如果是单个sample进行测试,那么就对单个sample进行更新,如果是多个sample作为一个batch,就对一个batch进行更新,如果是流式的,那么就迭代更新
在推理时,这里会先构造辅助损失的数据,然后进行参数更新,然后再进行预测
Experiment
这里的主任务图片分类
主实验之一 ,TTT显著提升扰动后的性能
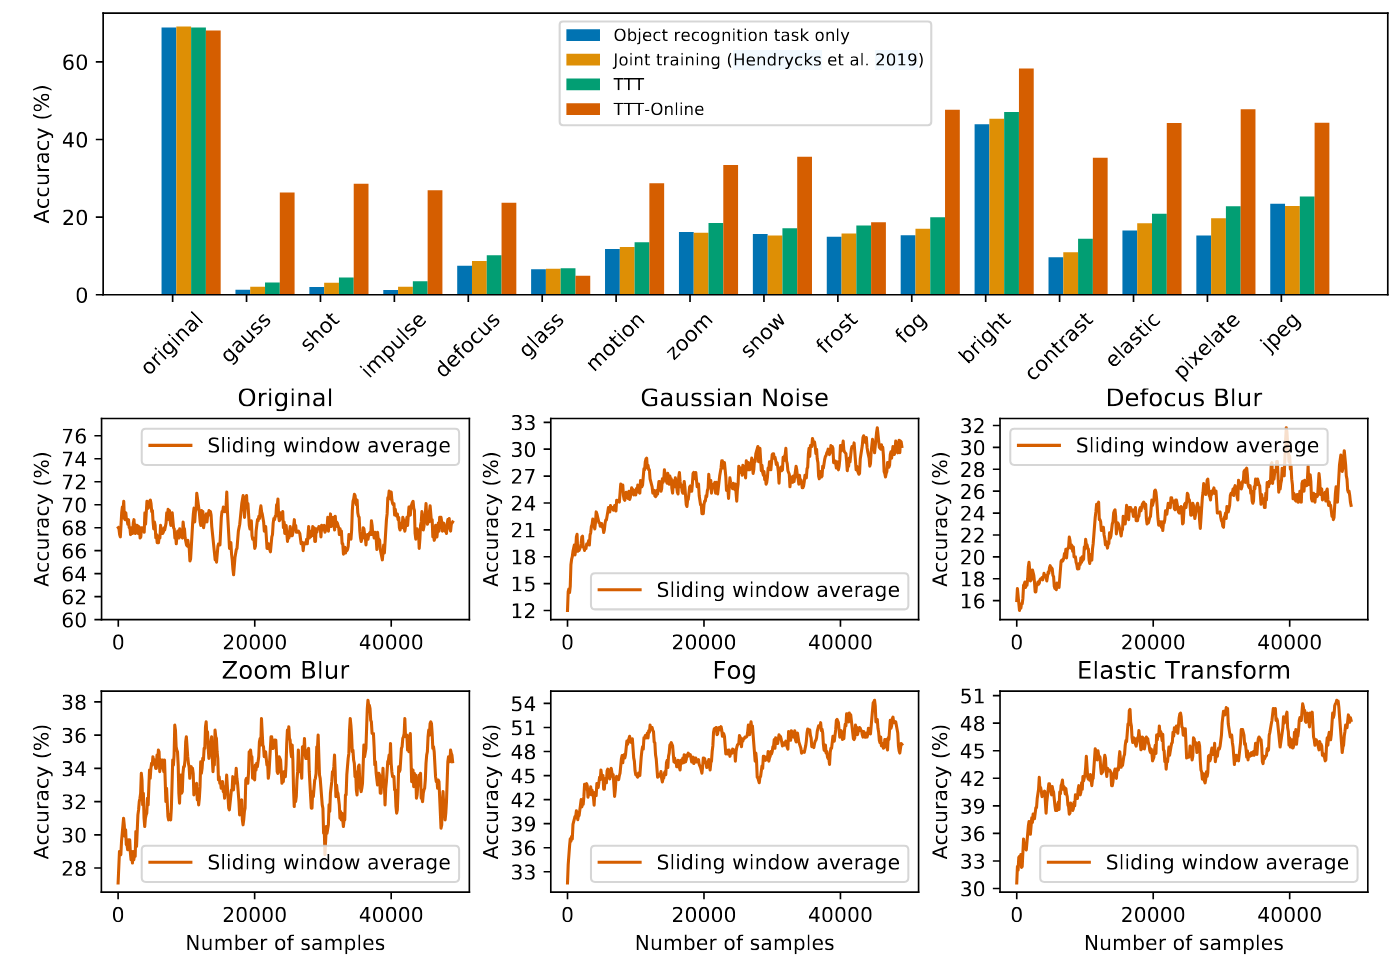
其他值得注意的实验结论
- 每张图片/每个sample,可能只需要更新一步
- 辅助损失的选择会影响性能
- Batch Norm等和batch统计相关的算子,可能会影响Test Time时的更新(因为Test Time 统计量会不准确)
- 辅助损失和主损失的梯度内积/余弦相似度应该为正
Development
Learning to (Learn at Test Time): RNNs with Expressive Hidden States 24/25
这篇工作应该和 Mamba2 是同期工作
Motivations
self attention 有平方复杂度,而RNN方法在long context下能力有限(论文称为limited expressive power),论文希望实现线性复杂度 + expressive hidden states
也就是使用TTT方法,让hidden state 能够自己自监督的更新(通过梯度进行更新,而不是受限的linear transform)
论文的叙事是,Mamba等RNN方法取得了LSTM以来的巨大进步,但是长上下文(16k以后),性能不如transformer。观察到SSL能够压缩massive training set同时展现出深入的语义理解,论文决定使用SSL把hidden state改成machin learninig model itself
这篇论文的第一作者也是YuSun,都很强调SSL
Methods
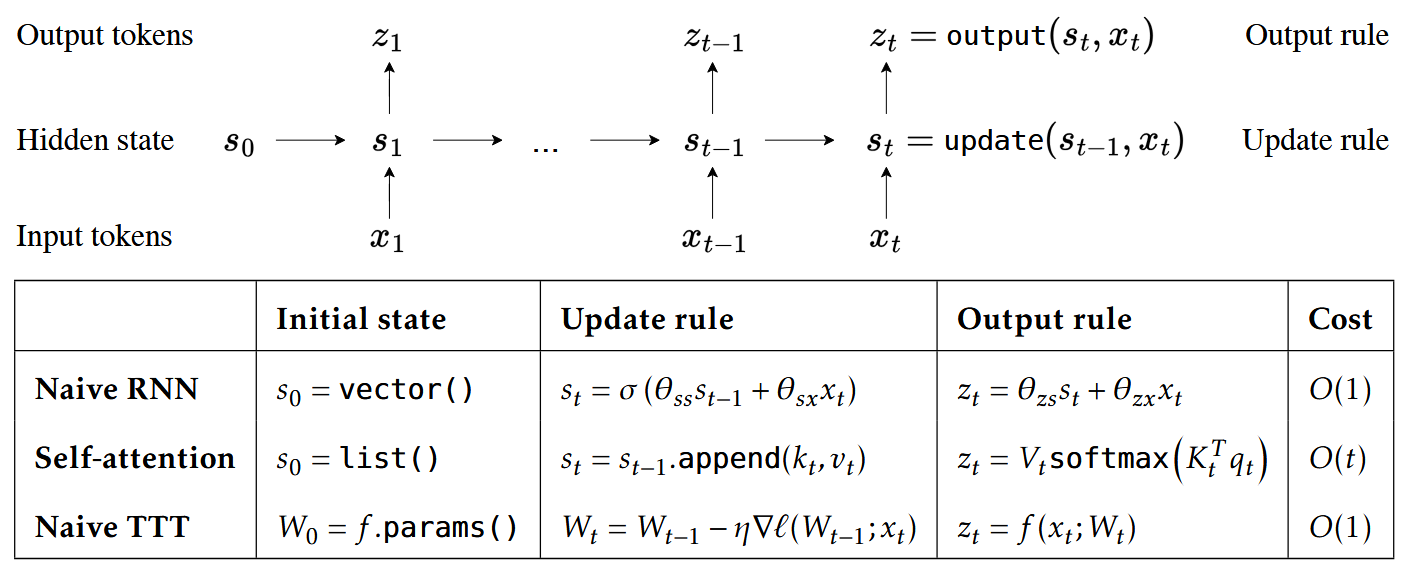 三种做法,可以被形式定义为 不同状态下拥有各自的update rule和output rule 的架构
- 对于现代RNN来说,状态一般是一个仿射更新的状态矩阵,它的update和output都是常数时间,空间也是常数级别的
- 对于transformer,从单个token递推来看,它的状态是历史的KV cache,它需要保留线性增长的KV cache状态,得到线性复杂度的attention score(只有一个分数向量),然后进行线性复杂度的读取
- 累计的推理是平方复杂度,同步进行多个token也是平方复杂度
我们希望通过SSL的方式(这里实际上特指LLM NTP模式)进行压缩,把training dataset压入到hidden state中
论文认为,LLM已经是一个良好的范式/模范:使用NTP(SSL),将训练数据压缩到参数(状态)中,同时表现良好
所以这里的做法可以基本一致,将任意模型的(部分)权重改成压缩记忆的hidden state,通过gradient step进行更新
损失的一个选择是重建,这里为了避免平凡解,需要对进行corrupt
Design
这里需要区分两个loop
inner loop是指,TTT的更新,而outer loop是指,模型剩余其他参数自己的更新
那论文具体是怎么设计的呢?
论文直接使用NTP来训练TTT layer,也就是本质不存在两个不同的loss(不同于第一篇joint training),这里直接让TTT的过程参与到NTP的loss中
首先看TTT的设计
TTT明显借鉴了attention的做法,对于输入,进行K projection (论文说这是进行corrupt),TTT自己的inner loss设计为 经过V投影的 和 K 投影的 的MSE
这里完成了训练,要求 TTT 参数能够进行k 和 v的关联
对于历史的输入,通过更新W来更新记忆
然后需要考虑读取(回到LLM),这里同样参考attention
这里的 维度和原本的LM维度是不一致的,这里维度的问题实际上通过多个head来解决(维度拼接),也就是说整个TTT部分,除了参数的更新之外,实际上是一个linear attention,这里的参数实际上就是hidden state
原文说的是,让hidden state成为model,这里的hidden state的意思可能是:hidden state的说法来自于RNN,这里希望丰富它的表达能力,所以要让hidden state作为一个model,具体做法参考了LLM的压缩理论之后,可以将hidden state等同于权重 在这里,权重本身并没有像hidden state一样写入了历史记忆,而更接近于它充当了一个预测器
为什么这样的TTT可以帮助到LLM的预测?
这里outer loop就是NTP,每次outer loop forward都会进行一次TTT layer的update和readout,所以梯度会回传给TTT layer,QKV投影和layer的参数W会在outer loop的训练下被塑造成对LM有帮助的参数
按照论文的说法,这里QKV投影后得到的结果,被称为multi view,和这里结合attention来理解在说法上有较大差别,但是个人认为这里与其说是一个multi view reconstruction,它更像来自于full attention或者linear attention
具体实现上,需要注意的有
- 有TTT-MLP和TTT-Linear两个变体
- 学习率是可学习的
- TTT layer取代某些attention layer
- 具体TTT layer的实现使用了transformer或者Mamba作为backbone
- QK共享线性投影,使用不同的short conv
- 加入了读取的门控
Parallelization
这里显然是有问题的,LM训练,即使是linear attention,对长序列也基本是并行的,但是内部TTT需要在序列上迭代更新 W
也就意味这里真的要实现TTT的设计,需要每个token都进行一次更新,并行受限
如果将这个迭代的过程拆开,可以得到
这样可以一步到达目标位置的权重,但是梯度的计算仍然无法跳步,论文在这里进行了妥协,让多个时间步依赖于同一个weight进行计算梯度
这样根据选中的时间跨度不同,可以得到曲线
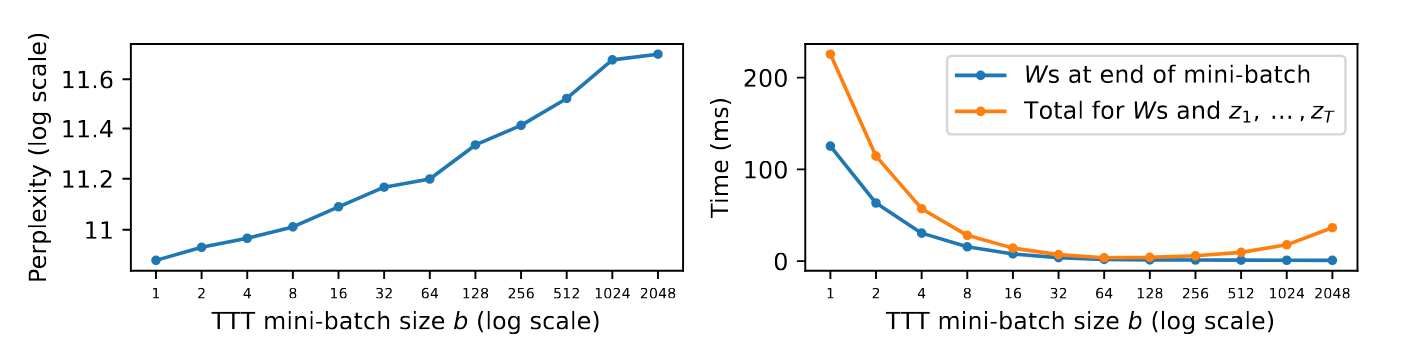 这样的实现下,只有梯度本身是有问题的,对于参数更新和读取的计算,因为参数的更新次数是正确的,所以没有问题
Dual form
parallelization让参数更新可以并行计算,但是这里的并行仍然不是GPU高效的方式
如果简化这里的计算,让QKV都变成identity
为了完成上面的并行设计,这里首先需要计算每个, 是一个的矩阵,首先存多个就很浪费内存,读写IO开销也会比较大,另一个是梯度的计算是向量外积,外积的形式,每个位置只有一次乘积,虽然可以并行计算,但是这不是高效利用GPU matmul的做法
所以作者希望再做一个优化,基于两个观察
- 我们只需要更新到最后的参数
- 我们只需要读取的输出而不需要中间的梯度
可以重写矩阵运算的式子
矩阵化变成
这里的mask保留了上三角,可以直接通过 理解
论文称这种做法为dual form,原本的做法为 primal form
原本的时间复杂度是 ,现在会额外加上 (计算z),这里说牺牲了理论复杂度来换取实际的效率提升
Other
除了这些内容之外,论文还理论证明了,在某些设计下,TTT可以转化为linear attention,或者softmax attention,这里的转化都是TTT进行特殊的配置后成立的,确实证明了TTT是更广泛的架构,不过个人认为并不能认为TTT真的能够实现linear attention和softmax attention的性能或者优于二者,这里有些“归纳偏置”究竟如何抉择的问题
Experiments
论文在pile(短上下文),books(长上下文)上进行了实验
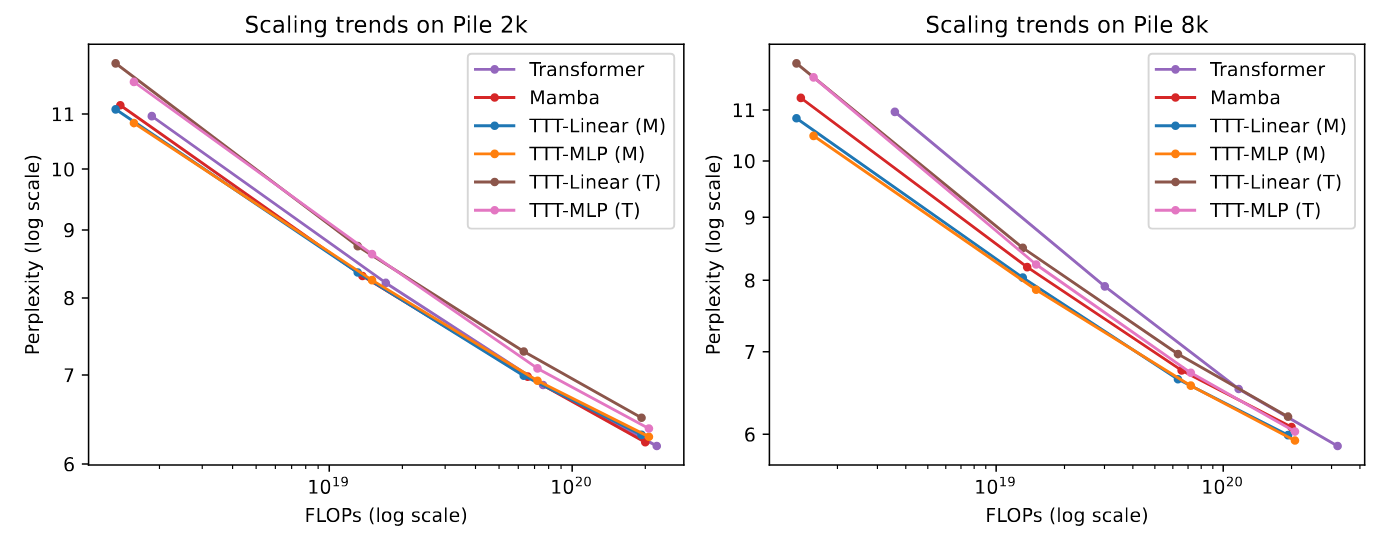
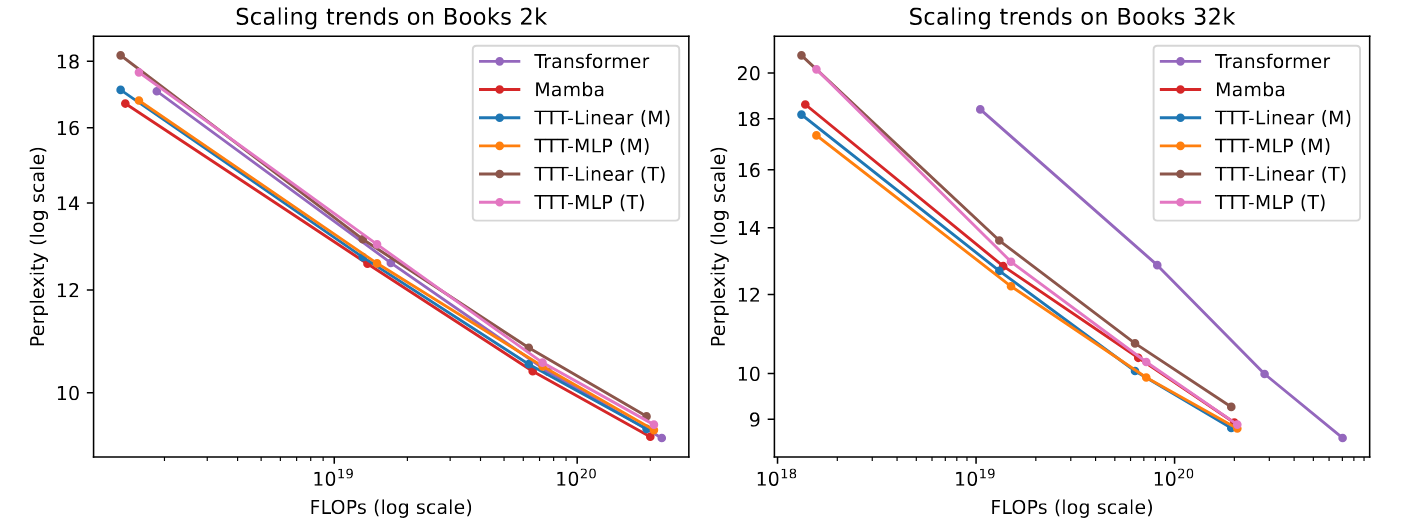
这里以transformer作为backbone的实现不如Mamba作为backbone的实现,TTT总体上体现出了相比起Mamba和Transformer更优秀的scaling表现
比起scaling law的实验(挺多架构都有这样的实验,但并不见得有效)
这里我比较感兴趣几个问题
- FLOPs在这里是怎么算的
- 不知道,代码里没有,这个感觉得溯源到scaling law的实现?
- 为什么transformer不如Mamba
- 论文认为可能是 短卷积 帮助 TTT 处理了局部信息,这里和LaCT混合结构,用SWA来处理有所对应
TTT Done Right(LaCT) 25
Motivation
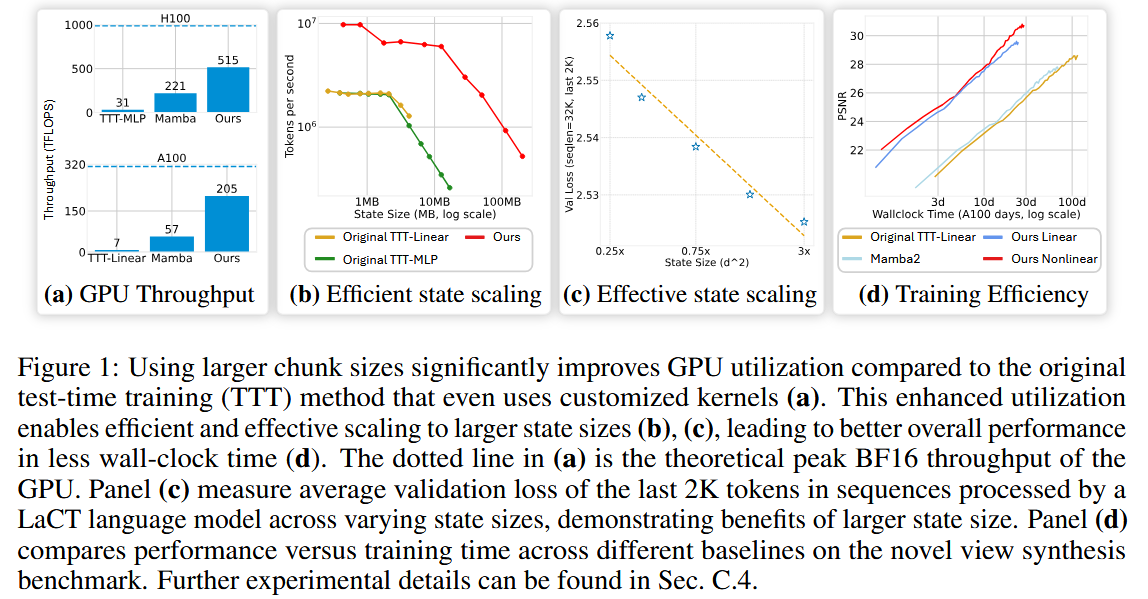
现有的TTT方法使用mini batch更新,这导致了许多问题:
- GPU利用率不高(10%),硬件/加速实现很复杂,难以scaling到long context中,也难以提升TTT的容量(2%,更多的是慢参数)
- 16/64 量级的token不适用于图片,3D等非1D序列的场景
论文直接进行large chunk的更新,显著提升了GPU利用率,同时在大量新任务上测试了这个做法的性能
Methods
Challenge
先前的工作经常实现定制化的kernel来进行加速,大概的意图都是把fast weight加载到SRAM中,希望尽可能在SRAM中就能够完成计算(而不需要大量的和HBM进行读写交互),但是这样要求计算能够在SM局部就完成(也就是不需要和其他的SM进行过多交流)。对于涉及更多大矩阵级别的计算(SwiGLU fast weight,Muon),这里无法满足。也就是这里受限于memory bandwidth,实现这样的kernel本身难度也比较大
如果直接用pytoch来写的话,虽然实现简单,对简单的MLP fast weight计算算术强度(arithmetic intensity/compute-to-memory ratio)的话
的矩阵大小, 的输入,的输出
计算的FLOPs,按照matmul的基本做法来算
| 数据 | 元素数量 | 字节数 |
|---|---|---|
| 权重 | ||
| 输入 | ||
| 输出 | ||
| 合计 |
代入具体数值计算的话,这里的效率相比起卡的性能来说很低
除此之外还得考虑long context,sequence的并行
- linear attention大多会根据自己的线性状态递推得到并行算法
- softmax attention可以使用online softmax
- TTT非线性更新,难以找到这么方便的做法
Architecture
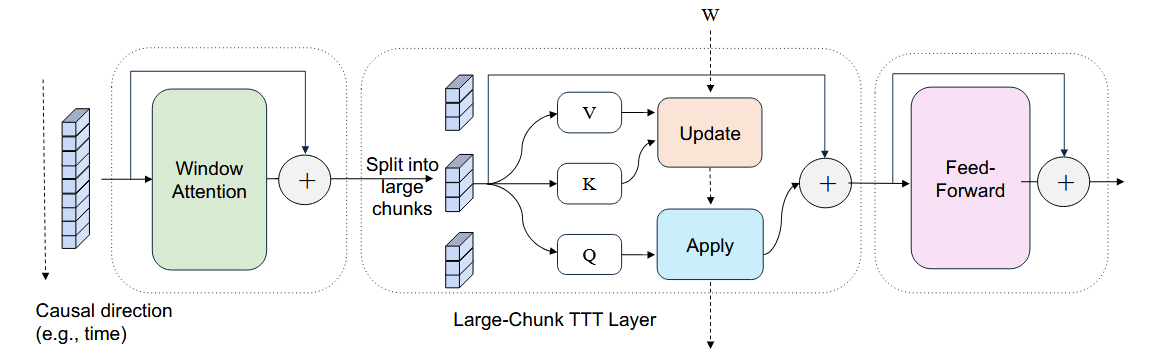 简单来说是,SWA + TTT(large chunk),是一个混合的架构
这里只做了基本的形式定义,有比较多的灵活性
梯度的计算同样是k和v之间的关联关系,不过这里把关联关系改成了内积
具体论文的TTT参数使用 SwiGLU-MLP(参考自现代LLM),基本计算为
改成内积之后,如果是线性特例,梯度为
整体形式更接近于linear attention
架构之间相互交融好吧
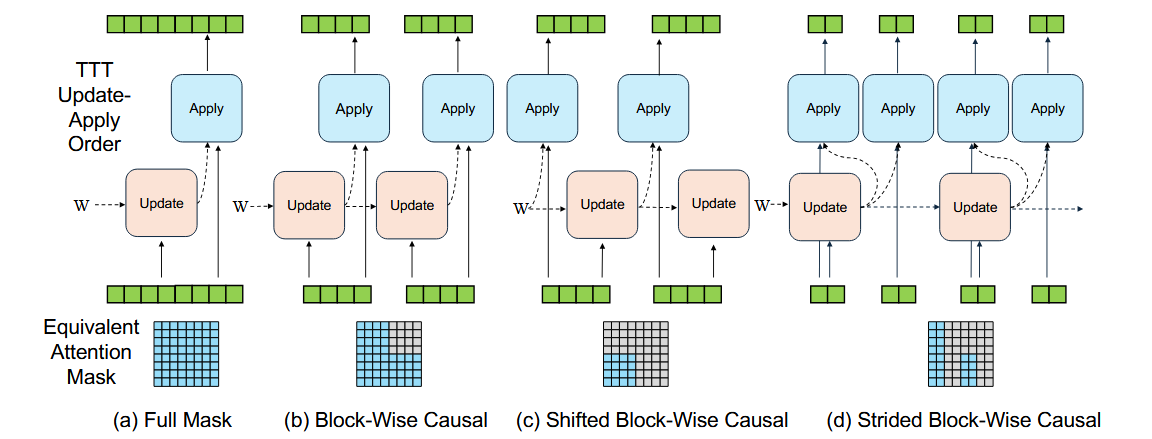
这里的灵活性支持处理不同的chunk大小,和不同的读取更新顺序,可以组成不同的mask
Non-linear update
论文在这里支持non linear的参数更新
具体的做法是,对更新后的参数矩阵分别进行L2 normalization,具体而言是对矩阵从输入维度到输出通道的权重当成一个向量,然后进行L2 normalization
这里论文提到了一个类比,如果只看时间维度下TTT参数的变化,这里可以类比为一个时间维度上的深度神经网络
- fast weight,W 是当前深度/时间的状态
- 经过某个新的chunk,进行某些运算/transform之后得到 残差分支的输出 梯度 g
- 梯度更新/残差相加
- 进行归一化
所以论文说这里归一化的做法类似于transformer中的post norm
挺有意思的说法,不知道这样的思考方式是否能够真的支持架构设计
除此之外,梯度的更新还可以采用Muon的更新规则
Context parallelism
梯度本来就是线性的,所以如果对同一个chunk内做context切分(共享同一个快参数),直接累加就可以
这里累加可以通过all-reduce-sum
Experiments
这里尝试了三个领域的任务
| 任务 | 一个 TTT chunk 是什么 | 谁写入快权重 | 如何读取 | 局部 attention |
|---|---|---|---|---|
| 新视角合成 | 全部输入图片的 token | 全部输入图片共同写入一次 | 输入与目标视角 token 都读取更新后的记忆 | 每张图片内部双向 attention |
| 语言建模 | 人为指定的 2K 或 4K token | 当前文本块 | 先读取历史记忆,再写入当前块 | 因果 SWA,补足近期逐 token 依赖 |
| 自回归视频扩散 | 一组连续视频帧的 token | 只有 clean chunks | noisy chunks 读取此前 clean chunks 形成的记忆 | 当前 noisy chunk 内部双向,并访问前一个 clean chunk |
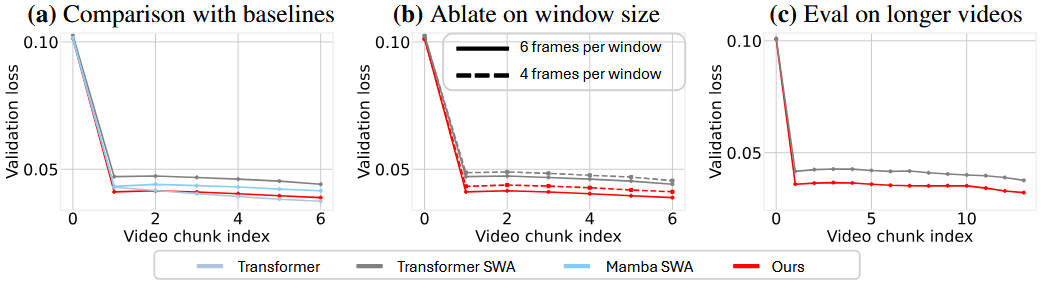
这里视频生成是基于Wan2.1微调的,把attention换成了LaCT + WA,Wan2.1自己不是一个AR chunk 生成的模型,所以这里时序是LaCT加入的
这里的实验总的来看,对当前时间点不是可能特别有价值(除非后续回来参考设计)
对于新视角生成任务(输入图像+相机参数)
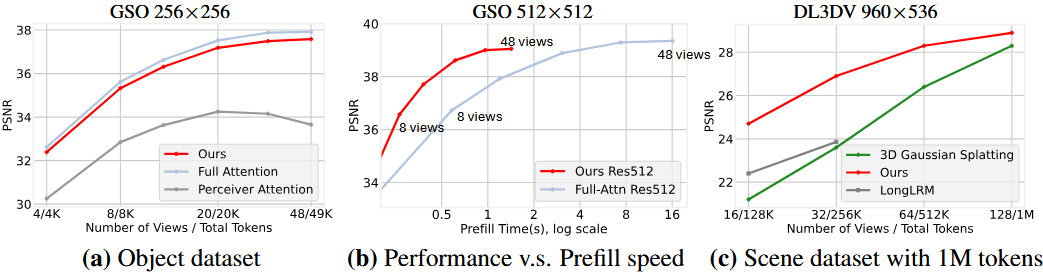 和transformer类似,远优于register token的实现,领先SOTA工作,而且可以scaling到1M
语言建模任务
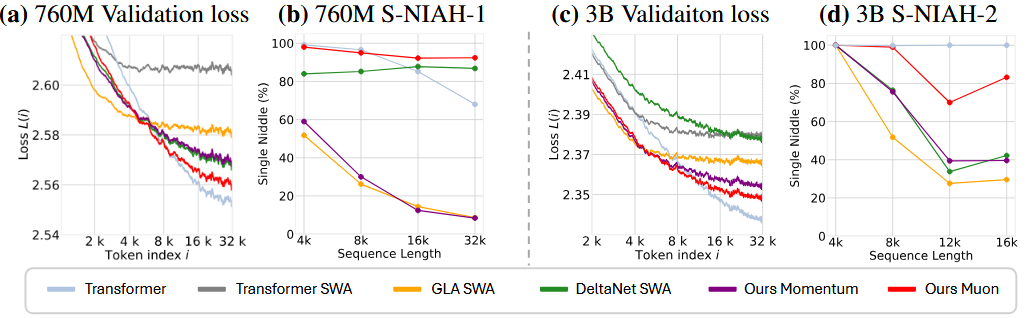
为了公平给别人也加上SWA,这里怎么没有一个scaling law曲线
不如transformer,领先于其他工作
视频生成任务
Conclusion
回过头来看,这里混合架构的做法在当时可能不是新的,但是这一类工作可能就已经给出了现在模型架构的基本选择
线性注意力广受工业界欢迎,而TTT似乎还没有出现在某个模型的架构中,这是因为什么呢?目前感觉主要问题还是复杂的更新机制并不适合scaling,LaCT尽管进行了大量简化,这里上下文的并行也没有被解决
看到这里,TTT看不到明确的优势
TTT-E2E 25.12
暂缓,远古时期看过,等有时间再回顾这篇论文
Average
正在我梳理的时候苏神更新了一个新博客,用这个博客来暂时告一段落
推广softmax的定义
softmax可以写成
博客希望建立起k 和 v的关联(在TTT/Linear attention中,二者往往会构建某种联系),所以引入分布 ,给定时, 的分布
如果取狄拉克分布,这里就可以恢复到原本的softmax形式
在理想情况下,所有输入,会有唯一确定的使得优化结果最好,但是我们希望的是压缩,不是对每个都去算出对应的,而是通过学习某种分布的做法来得到
博客选择了条件正态分布
其中 W 是模型参数, 是均值预测模型,按照(2)式,输出变成
接下来问题就变成怎么得到 W
流式更新
估计W,可以将 作为训练数据来训练 W
这里我们得到的形式已经是TTT的基本形式了,但是它仍然基于注意力分数对V加权和的计算
所以即使我们可以预测出 v,这里仍然需要K cache来计算attention
压缩/平均 K
要压缩K需要去掉attention的计算,改成近似或者预测
引入平均场近似(假设k的加权平均的预测等于预测的加权平均)
如果预测器是线性的,这个近似就是精确的 预测器内部实际上是一个 K=V的softmax attention
假设k垂直于q的分量加权平均为0,那么加权之后的结果就是和q平均的k的分量和q的加权
把 吸收进q中
到这里形式就和TTT完全一致,KV都不再需要缓存
梳理
从softmax attention到TTT,这里进行了三次平均/近似
- 通过平均预测器来替代v,消除了V cache
- 预测器的做法肯定不如逐个得到k,v配对,不过苏神认为流式更新加强了token交互,可能差别不大
- 平均场近似 ,非线性的W不直接支持这个近似,这里数学上大概不成立,苏神认为这只是把attention从输出放到输入,可能影响也不大
- 但是这里让K=V,而不是KV有各自的表达,理应还是有影响的? (实则已经有K=V的attention实现了)
- 加权平均近似 ,这意味着K=V的attention,输出结果和q平行
- MLA,DSV4本质都是K=V的MQA,如果attn输出只相当于q,这里无法支持token之间的建模
苏神认为,最后一步这里过于理想了,需要定时补回softmax attention才能补回差距,也就是hybrid的结构
苏神在最后补充了将预测器改成线性的推导,线性设置下可以直接得到DeltaNet,参数更新也可以改成解析解
Embodied
RoboTTT 26.07
Jim Fan, Li FeiFei
Motivation
现有policy基本只有短上下文(论文称为visumotor context,视觉运动上下文),认为长上下文有如下好处
- LLM中长上下文是scaling axis
- 长上下文可以解锁in context learning,online learning,长程任务
contribution
通过RoboTTT,论文发现
- 性能提升,解锁长程任务(10个阶段,5分钟任务)
- context scaling可以稳定带来性能提升
Methods
几个值得注意的技术实现
- TTT
- DAgger distillation
- TBPTT
Test Time Training/Architecture
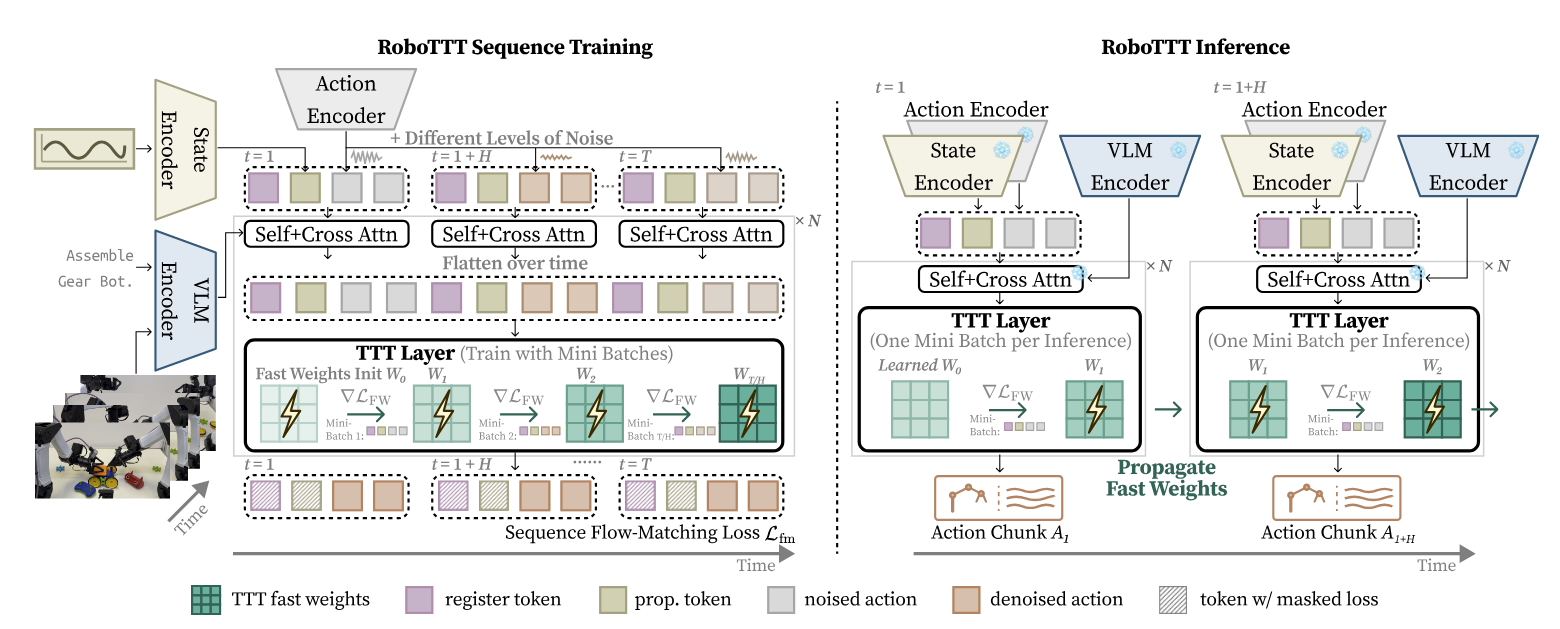 首先是架构设计,这是一个VLA + action dit的架构,TTT layer加在了attention后面。
action dit接受 viusal tokens,机器人状态,noisy action,register token,不考虑具体长度影响,在T个chunk下,模型输入T个时刻的chunk,直接输入包括机器人状态状态,noisy token,register token,visual 信息通过cross attention获取
而对于TTT输出,这里引入了门控机制,使用一个d维的可学习参数 来控制TTT和attention的输出结果
这里TTT的具体结构和TTT layer论文一致,具体是一个MLP,有QKV投影等内容,直接加在了action expert后面,没有取代其他参数(所有层都加入了TTT layer)
Training
首先是基本的训练设计
这里的训练也和TTT layer论文一致,inner loop直接参与到outer loop的优化中来优化慢参数和初始化快参数,
这里和TTT layer不一样的只有目标损失和一些技术细节
- 损失是action flow matching loss
- 发现每个chunk的diffusion step 需要独立采样(对于一条episode),要不然会出现训练不稳定
- 使用了TBPTT
除此之外有一些针对具身场景的训练设计优化
TTT的一个特点是,inner loop和outer loop并不一定要同时进行,可以使用mask盖掉没有动作标记的数据,给TTT提供上下文
- 在in context learning的场景,先给一段人类示范,然后再给机器人轨迹来训练机器人进行上下文学习
- 在纠错的场景,通过DAgger进行纠错,这里可以盖掉机器人的错误动作,只提供机器人错误的上下文,然后学习纠正部分的动作,来训练模型理解错误和进行纠错
Experiments
主实验,这里的baseline分别是 当前时刻观测,加一个历史帧,改成用GDN,这里没有给出详细的baseline实现
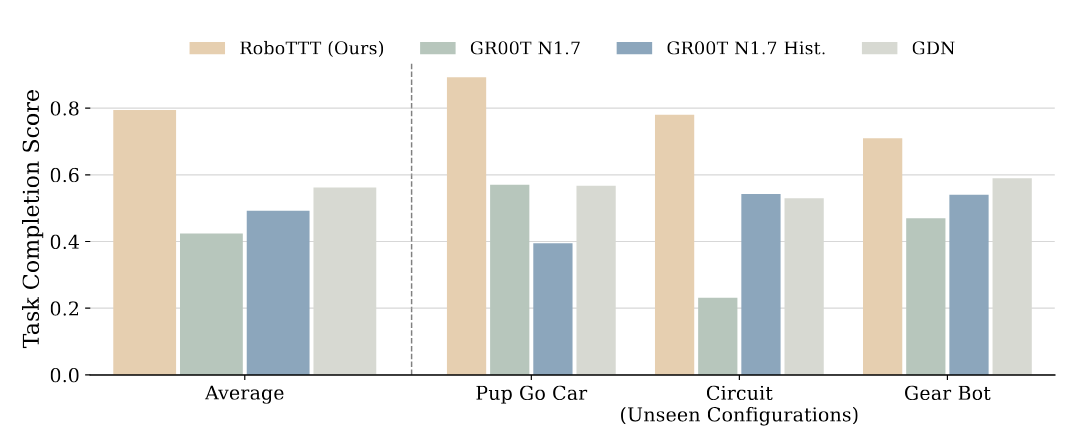 论文发现了TTT的三个优势
- 对于多阶段任务,两个阶段的场景相近,baseline可能会重复执行相同任务,而TTT可以避免这一点
- 如果出现了失败,TTT可以进行纠正,baseline会继续完成
- TTT的动作更加精准
context scaling实验,TTT的性能随着训练context scaling而提升,这里的baseline分别是
- 使用GDN替换TTT layer
- 同样是一个历史帧变体(short context)
- 原本的GR00T N1.7
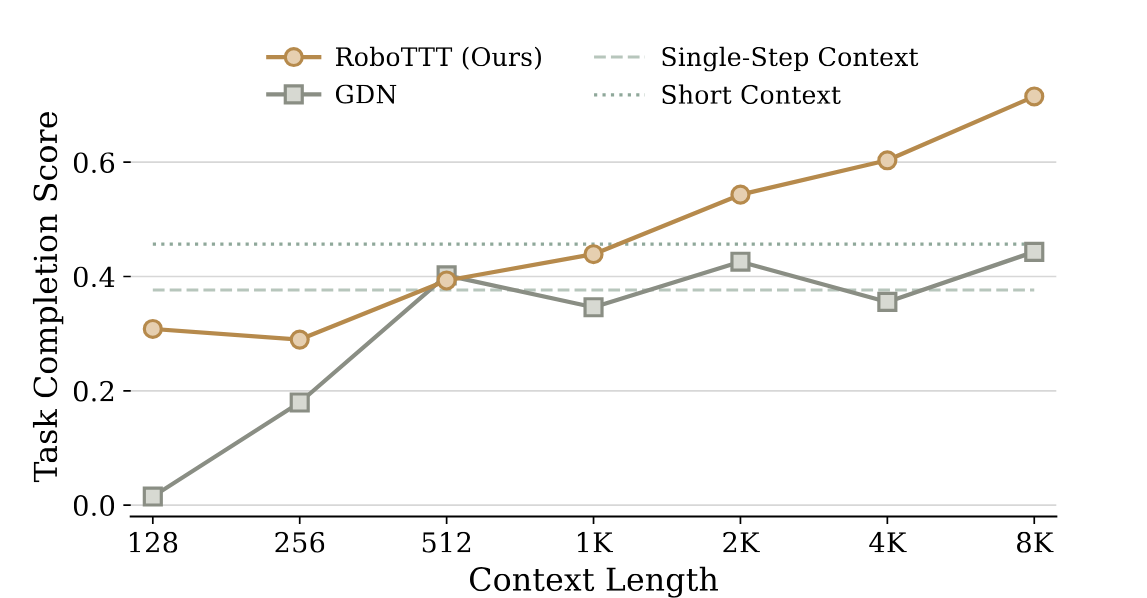
这里是有点奇怪的,TTT和GDN变体,各自在context到达1K之前,都不如只有一个历史帧的变体,需要长达1K 步的训练设置才能让TTT到达基本的性能吗 论文这里试着解释了为什么1K之前表现比较差,归因于1K短于任务轨迹,所以这里会出现超出训练的TTT更新长度,导致需要外推,真是如此的话这里TTT的训练方法外推能力有点太弱了
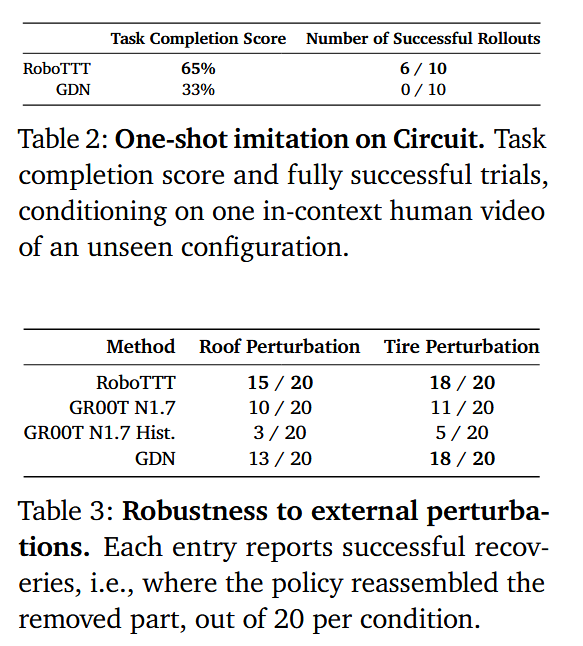
相比起GDN,虽然GDN也能够encode 上下文信息,但是TTT能够更好的学会如何进行In context learning,模仿人类专家的动作
同时,TTT对干扰场景也有更强的泛化能力(这里的干扰是在rollout过程去掉某个东西)
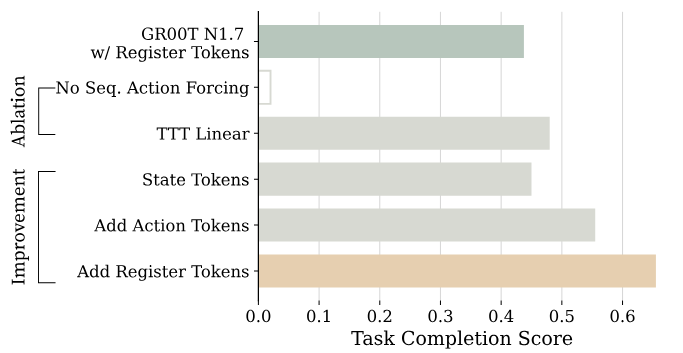
消融实验
Conclusion
RoboTTT是比较有代表性的工作,算力要求也达到了32卡水平,不愧是英伟达的工作。TTT在这里展示了很多优点:
- 不需要缓存历史KV,计算复杂度空间复杂度保持常数级别
- 每次新处理是常数,整体是O(T)
- 天然适合于context learning,用于ICL或者纠错
- 似乎能够学习一下历史观测/操作信息来提升动作的精确性
但是论文没有真的和memory系列的文章比较过,baseline最多也就是一个历史帧而已,这里TTT的性能本身是一个比较大的问题
T2Mem
Jiajun Wu,Li FeiFei
Motivation
memory不应该是原样存储,而应该是以能够指导未来动作的方式存储,所以memory不能只是存在observation或者是完整的交互历史,而应该是 让动作来影响memory的构建,然后memory来指导未来动作 (很强的claim)
- 显式的记忆
- 如果出现了(上下文有限)信息丢失或者distorted,无法恢复
- 记忆也无法直接用于指导动作决策,认为需要是隐式的表达(方便模型直接使用)
- TTT提供了一个符合要求的做法
- 但是TTT only无法保证memory的存储真的有利于动作决策
- 希望探究能否让一个pretrained model支持memory而不需要引入 larger external model
提出observation-grounded memory interface encode observation info,和alternating memory polciy learning 给memory和policy提供fixed counterpart用于学习
这里对记忆的说法比较强行,不见得一定需要隐式的记忆,只要模型本身支持理解就没有太大问题,TTT类似于RoboTTT的实现,fast weight update的meta learning,本身学的就是怎么让action预测更好
Methods
Architecture
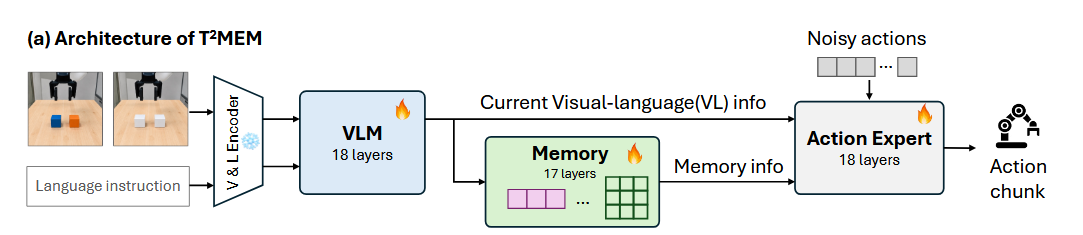 首先是一个VLA(pi0.5),记忆接受visual + language info,action expert额外接受memory信息
具体而言
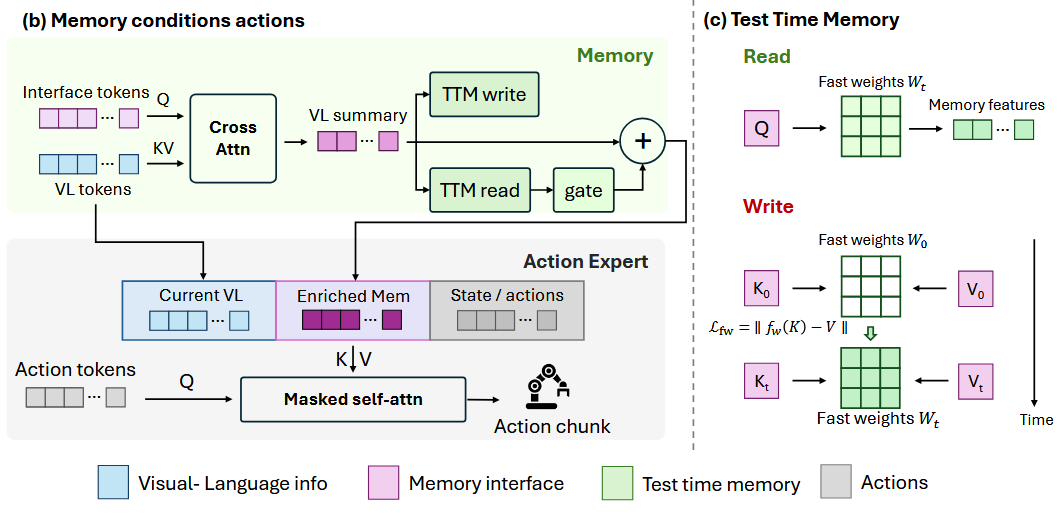
这里和RoboTTT基本是一致的,只是memory的位置不同而已
首先会有learnable query来压缩VLM输出的representation,得到的summary会用于TTT的更新,也就是作为TTT的输入,read就是读取操作,write就是KV的匹配和参数更新。最终得到的读取结果会经过gate加回summary,输入给action expert
然后是一段个人认为论文的说明和架构图都很混乱的地方
这里action expert的输入包含原始的VL信息,memory输入,机器人状态,图中绘制的是action token作为query,其他提供KV,但是attention确是self attention,同时还有特殊设计的mask
代码也没有开源btw
这里究竟是怎么回事呢?
首先这里基于pi0.5,是一个MoT结构,所以架构图简直是乱画,论文没有说明TTT参数具体在哪里,可能是独立的stream,具体而言它每一层TTT layer是一个MLP,每次读取到的结果给下一层action使用,按照论文的说法,这里是得到action chunk之后再更新参数,参数更新和原TTT顺序不一致
所有token包括:VL token,memory输出/interface,action,state
这里的attention mask,论文没有给出完整的attention mask矩阵,只是特别强调了:interface内部不相互attend,只能attend VL,论文认为这样可以避免通过动作直接外推决策,而不是记忆关键信息
Training
训练有两个部分,一个是Alternating Memory–Policy Learning,一个是Adaptive Self-Supervised Memory
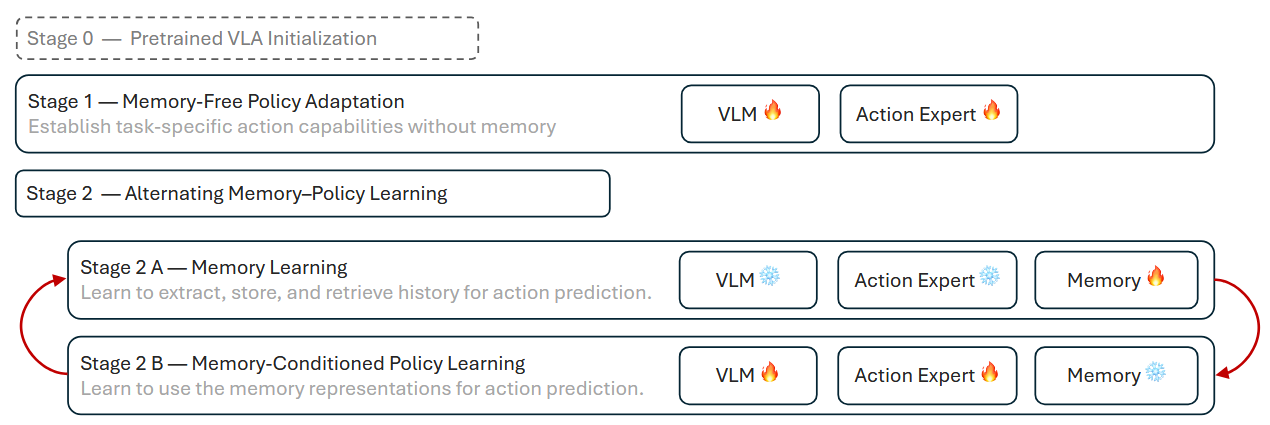 Alternating Memory–Policy Learning,进行warmup后,交替训练memory慢参数和其他参数,具体是各自更新500步
这么设计的原因是,记忆慢参数的更新会改变policy的输入分布,policy需要适应新的记忆表示,policy更新会影响action loss的对memory的更新,也就是memory之前学到的记忆表示可能在policy更新后响应又不相同,所以这里分阶段训练
这里可能更接近于实验发现的现象,本身慢参数就是模型的一部分,损失相同,这里和同一个模型没有太大的区别,唯一的区别就是确实 快参数和慢参数的关系 会比其他架构带来更大的影响
Adaptive Self-Supervised Memory
这里希望给memory的写入加一个权重来避免相似内容的重复强调,加入一个更新步长来优化学习率设计,所以设计了一个启发式的做法
对于权重,先计算累积更新和当前更新的相似度(是否已有该方向信息),再计算当前KV的匹配程度(是否根据当前记忆能够很好预测),然后得到权重
对于步长,设计一套根据曲率校准的做法,比较复杂
这两个需要的时候回到论文阅读应该就可以
Experiments
主实验
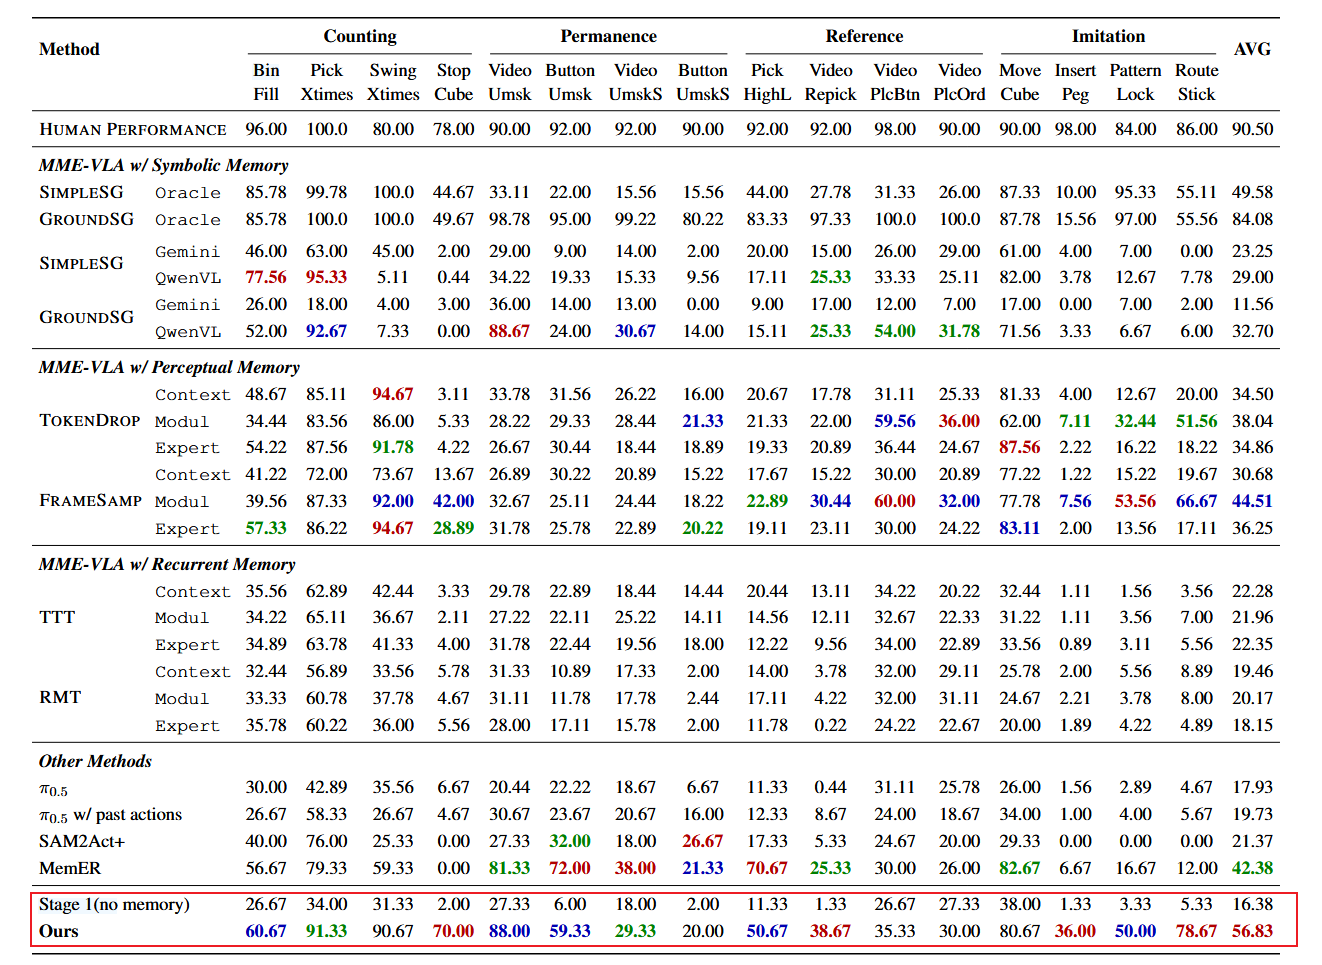
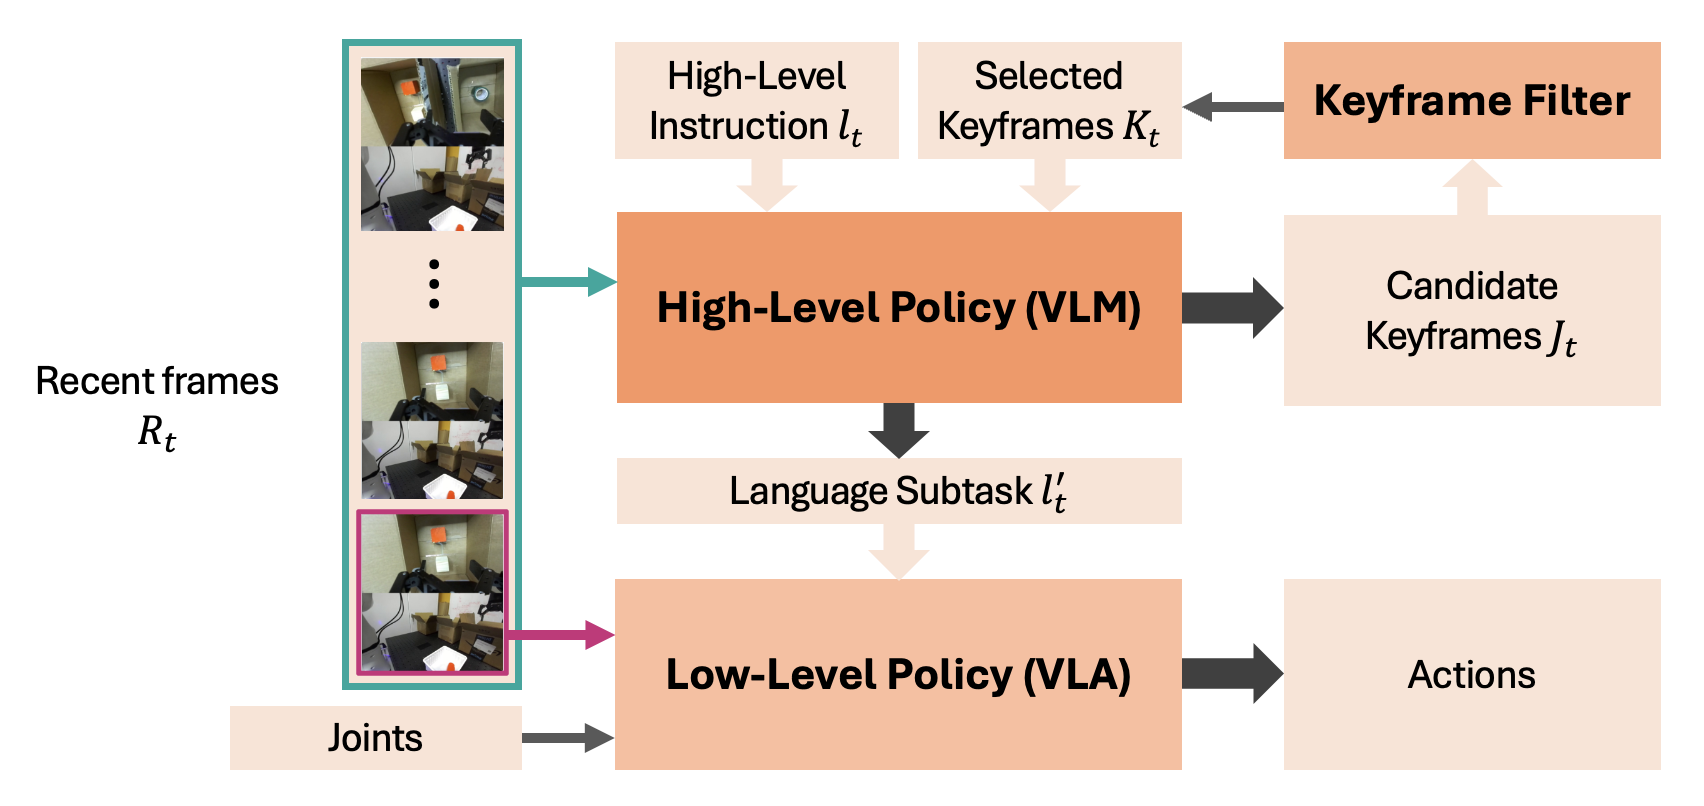
MemER是一个VLM维护历史记忆,输出子任务,记忆模块筛选关键帧,VLA作为policy执行动作的框架
消融实验
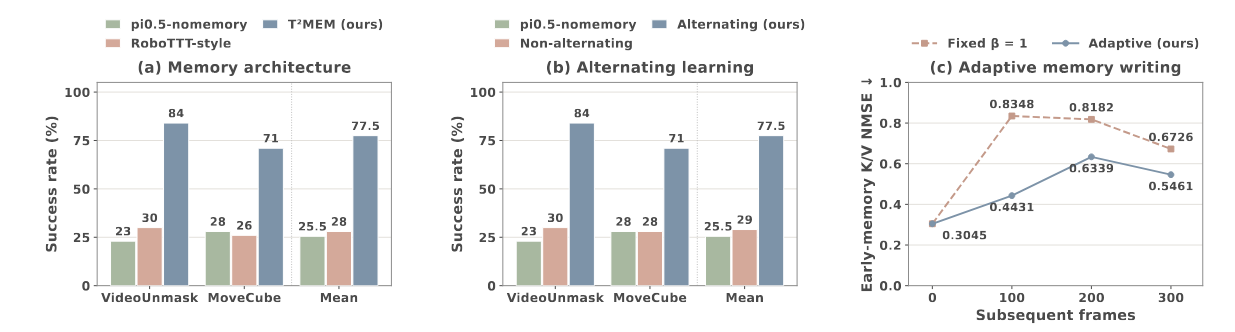 这里主要是和RoboTTT的对比,和adaptive memory writing的作用
RoboTTT-style是按照RoboTTT的做法,加入自己的交替训练和自适应写入之后的结果,性能差别很大,有点奇怪,似乎两个做法差别并不是很大,RoboTTT也有视觉信息的记忆读写,这里要么是实现有问题(按照附录这里似乎没有RoboTTT的query token获取视觉信息),要么可能是T2Mem中visual interface的做法更利于记忆学习对视觉信息的压缩
adaptive实验探究旧的K能否预测出旧的V,也就是记忆的存储性能,加入adaptive之后确实好了很多
成本/延迟实验
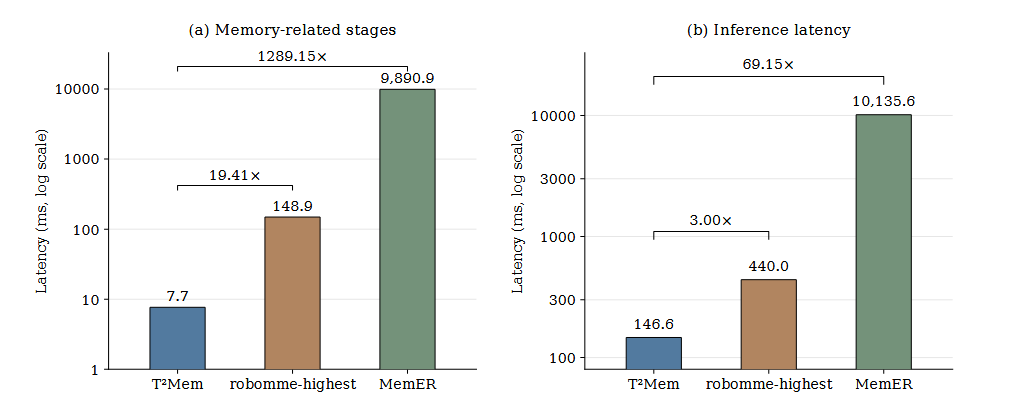 这里对比的中间位置是 RoboMME的baseline,大概是一个显式采样图像记忆,cross attention加入记忆的做法
TTT看起来似乎速度还可以,pi0.5在4090上的速度是 76ms,而T2Mem在A5000上是146.6ms,从数据来看A5000的速度是4090速度的1/2,所以这里似乎TTT没有太大影响?
Conclusion
论文写得比较难读,特别是设计的细节,花费了很多时间来理解,当然可能是我的问题,看完之后没有太多的启发
- 这里的TTT设计和RoboTTT都来自于TTT-layer,似乎往后的其他TTT工作还没有被运用到具身领域
- 论文主要强调的是动作和记忆应该是相互的,但是没有看到和这个出发点很相关的设计
- T2Mem性能好在哪里,可能在于
- 相比起RoboTTT更强调了VL info,也就是对具体视觉信息的压缩
- 相比起RoboTTT的架构,MoT更难让TTT在没有bottleneck的时候训好
Summary
苏神的博客解释了为什么Test Time Traninig性能有限,LaCT可以看出Test Time Training在scaling上还有许多问题需要解决
只把Test Time Training当成一种更fancy的Linear attention的话,目前它的实现好像确实没有更吸引人的地方?也就是同样作为一个压缩化的attention,目前架构的范式,的的确确证明了attention is all you need
但是回到Test Time Training的设计初衷,持续学习大概可能难以通过压缩的方式来解决?除非是 harness + foundation model + 系列infra的系统化工程,有没有可能TTT可以作为真正的测试时学习的持续学习的突破口呢?
就目前而言,具身里TTT似乎也无法作为长时历史的主要结构,可能作为一个辅助更合理。