LeCun of cause,一作是 Randall Balestriero
看到一半发现数学的要求远超出我的水平,即使和AI迭代也比较难真的理解,所以几乎所有命题和定理都会根据我的理解进行简化,一定程度会丢失原意,建议结合原文理解
[2610.39302] Proving and Improving the Platonic Representation Hypothesis with JEPAs
Motivation
论文希望证明柏拉图假说(Platonic Representation Hypothesis, RPH),世界的不同模态的相同事物的表征会收敛到相同的表征上(as they scale)
假说没有被论证过,只是一个猜想,所以论文希望探究:when do models, trained separately on different modalities, provably learn the same representation?
Intro里涉及到较多其他工作,在这里补充一下
- 什么是PRH,大概内容是什么
- 柏拉图认为,存在一个理想世界,当前世界的事物是理想世界的投影,PRH借用了这个说法,认为即使模型的数据,模态,训练目标不同,随着规模和能力提升,会学到一个共同的世界统计结构
- 例如两个不同的表征空间中,近邻比较一致,kernel相同(所有样本内积相同也就是关系相同),只差一个正交变换,
- 除此之外论文还引用了其他理论,Helmholtz的无意识推断,大概内容是感知会根据感觉输入和过去经验,自动推断外部世界的原因,我们直接体验到推断结果而不是推断过程
- Barlow冗余减少假说:自然感觉输入存在大量冗余
- 柏拉图认为,存在一个理想世界,当前世界的事物是理想世界的投影,PRH借用了这个说法,认为即使模型的数据,模态,训练目标不同,随着规模和能力提升,会学到一个共同的世界统计结构
- 现有的相关工作已经证明了什么
- 可以通过线性映射联系两种不同的语言的embedding
- 在线性模型,线性目标,SGD下PRH被证明严格成立
- 多语言模型内部特别是中间层有相似的表征
- 为什么要在JEPA上独立做证明
- 实际上其他领域对PRH已经有了一些证明,这里比起说是想证明PRH,可能还有想给JEPA正名之类的目的
论文的insight是:PRH是关于正样本的理论,JEPA的正样本如果是不同observation of the same scene,那么学到的就是属于world的表征,如果正样本是 一个observation的corruptions,那么学到的就是属于当前模态的表征
论文claim的核心贡献有:
- 证明了PRH:turn the PRH into a theorem
- 证明NTP是 bad-view JEPA
- 通过good view提出了对齐的scaling law
- 通过good view的模型对齐性能超过了70B的语言模型
- 在没有训练caption的情况下实现了caption(仍然是PRH的证明)
具体细节到下文再展开
看来论文内容会很难读,以我的数学水平大概只能了解一二
Methods
Shared Positives Provably Make Representations Platonic
Platonic Representation Theorem
论文希望形式化PRH为一个定理,这里需要先给出定义
将world定义为一个状态集合 ,,有不同模态可以observe it(z),得到自己的render结果(单射,不同状态不同结果,同时可逆),
存在联合分布 描述两个positive pairs的采样概率
它首先是对称的
这里明明是正样本对,为什么是z和z’?这里使用了更广泛的定义,如果要求一致,那么分布就只集中在对角线上,可能也可以理解为差别很小的世界状态也可以被定义为正样本对
任意一个边缘分布都服从 p
那么一个使用positive pairs训练的encoder就是在最小化
是encoder,第一项是预测项损失(这里的预测使用identity,JEPA WM可以有预测器),第二项是防止坍缩的损失,的只对的输出进行约束
定义Q rotation(正交变换),满足 ,旋转不会影响正则项,不会影响损失计算
将f和g复合,可以得到
由此定义 Theorem 1
每个模态的正样本联合分布都满足 ,存在一个最小化的解/embedding,,其他所有模态都可以由这个embedding进行正交变换/旋转得到解
任意两个模态差一个变换
这里的 只需要是最优解,不需要是特殊某个模态的解,所以这里选定任意模态都可以得到线性映射来实现模态迁移
也就是 的最小化解在旋转意义下唯一
那什么时候可以满足呢?论文希望论证JEPA系列是有满足的基础的,所以有命题1
Proposition 1
在损失为平方误差, 为施加白化约束(),embedding维度小于世界状态数,可以证明最小损失由邻接矩阵的特征值决定 。如果要求特征值不存在相同(谱间隙满足 ),那么最小解为
这里需要补充一些内容
这里白化是指,让分布均值为0,协方差为单位阵(任意维度方差为1)
这里的邻接矩阵是指归一化邻接矩阵,定义为
令 为正样本分布构成的矩阵,令 ,令 K为 ,则K是归一化的邻接矩阵,展开来看的话是这样的
从图的角度来看, 是世界状态加权无向图,每个位置两个正样本之间的权重,D是这张图的度矩阵(行和,每行边缘分布都满足p)
任意一个K的值为
所以K的每个位置是 当前的边权除以各自的度的几何平均值
K的特征值为
为什么要给出 K 呢? 这里肯定是后面推导的时候用到了,没有深入看数学推导,一个(和AI讨论)的直观是,原本并不需要K,损失是在的意义上计算均值,但是这里引入了白化,所以需要有一个额外的归一化(因为白化对方差进行了约束)
SIGReg是满足白化条件的一种正则化,但是SIGReg会引入高斯的误差约束,影响了objective,所以目前SIGReg不一定满足这个命题,论文目前假设它满足
When Positives Differ
但是现实中,同个世界状态的不同模态的正样本对分布往往是不同的
对于不同的情况,有定理 2
Theorem 2 Kernel Mismatch Bounds Misalignment
仍然满足边缘分布, 是他们各自的spectral embedding,令的谱间隙大于0,那么施加最优旋转之后有误差上界
:谱范数,衡量矩阵沿最受影响方向的作用大小。 :Frobenius 范数,即所有矩阵元素的平方和再开平方,衡量整体差异
也就是说误差上界是由两个K矩阵决定的,这里论文分成了两个部分,一个部分是两个矩阵的差异,另一个部分是前面的分母 ,也就是谱间隙
这里谱嵌入在说什么?为什么要考虑谱嵌入的误差?
谱嵌入是训练目标的最优解,也就是其他都不考虑的情况下,模态编码器得到嵌入的最优解。在定理三的nuisance没有引入的情况,一个世界状态对应一个表示,而定理三的embedding不只由z决定
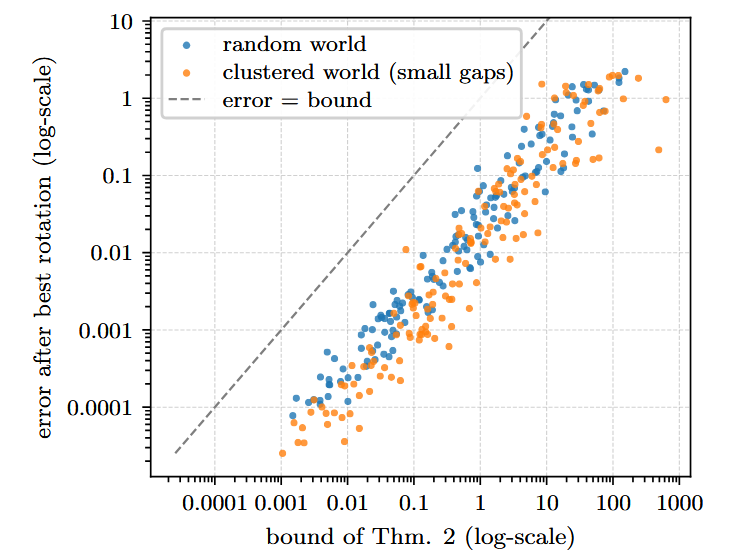 实验的实际误差和误差上界比为 0.18
到这里都只讨论了最优旋转存在,那么如何找到这个最优旋转?
Proposition 2: k Pairs Identify the Rotation
在当前的设置下,已经白化了的embedding,无论施加任意正交变换都会是白化的,所以一二阶矩等信息无法用于找到最优旋转 Q;选择n个世界状态,,k是embedding维度,在优化目标
Q就是R的唯一最小解
这个证明没有涵盖嵌入维度不同的情况
这里n个世界状态指的是得到n对世界状态对(跨模态),例如两个模态根据n个世界状态(可重复)得到了n对匹配对,单拿一个模态出来,要求这个模态的这些嵌入表示满足秩大于k
到目前为止,我们证明了,在正样本对训练的两个模态的编码器的基础下,只要损失函数和约束符合要求,就存在最优旋转(或者一个存在误差上界的旋转)来进行两个模态的迁移,而这个最优旋转只需要找到大于等于维度k的n个世界状态,获取n个跨模态匹配对,满足秩大于k就可以求解
尽管假设比较多,但是结论还是比较鲜明的
Good view and Bad view JEPAs
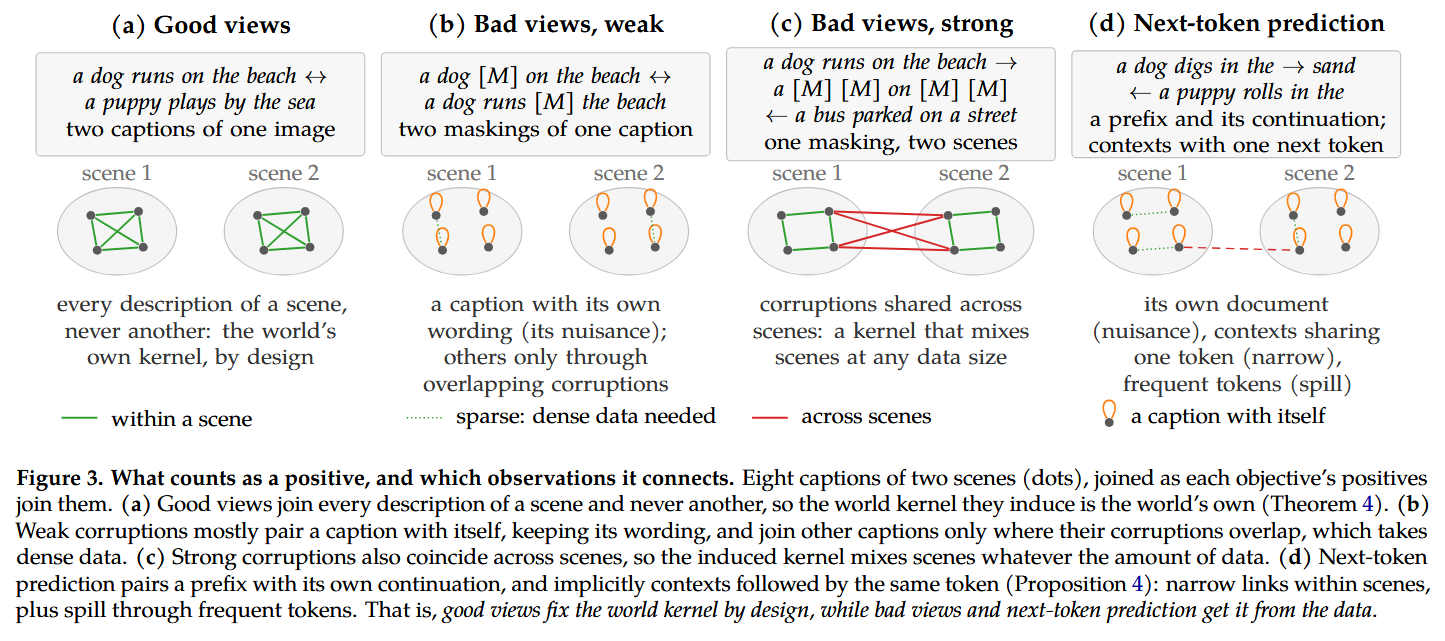
Good view是指,同一个世界状态的不同观测,bad view是指同一个世界状态,同一个观测的不同扰动
论文引入了v来描述观测的干扰因素 ,不同模态的观测可能携带这个模态特有的信息,例如相机的角度,文本可能没有包含这一信息,所以没有信息能够用来对齐
good view变成
bad view则是相同的世界状态z和相同的干扰因素v,只是后续自己施加的corrupt不同
这里论文希望衡量这个干扰因素带来的误差,所以引入如下的内容
固定一个模态和一个世界状态,编码器得到的embedding的均值(z的一个平均表示),随不同世界状态变化的协方差:
对特征值(沿特征方向,各状态平均embedding的方差),取根号然后相加,除以k得到维度各个方向的平均值,作为
总的协方差为
我们进行了白化,总协方差为1,不同状态间波动越大,同一状态内波动越少,也就是 越大, 越大,nuisance误差越小
如果 ,那么 只由z决定
有观测嵌入经过旋转之后的误差下界
那对于JEPA呢,JEPA的good view无所谓nuisance
Proposition 3
(在命题1的背景下)如果 ,那么good view JEPA 的表示和nuisance无关,而bad view JEPA,只要 ,就无法避免受到nuisance的影响
这里简单说明一下(不精确,表达有问题,但是方便理解)
对于good view来说,两个正样本的nuisance之间没有什么关系(使得依赖于v的谱上的特征值因为没有相关性,所以为0)
在谱上,只依赖于z的方向保留了命题1的(世界核)特征值,而依赖于v的分量特征值为0,所以只要第k个特征值也大于0,那么就和nuisance没有什么关系
对于bad view来说,额外的扰动会施加在nuisance上, 为最大的依赖于v的特征值, 为第k个特征值,因为两个v相同,所以这里依赖于v的特征值不一定为0,它有更大的可能保留误差
good view让k维度的embedding更多的关注于世界状态本身,而bad view会分配一些维度去关注nuisance
到目前为止,都是给定世界状态对/世界核 ,现在我们需要回到实际数据上,也就是我们的世界核是从真实数据得到的
真实世界数据和这里的主要区别有两个,一个是可能nuisance本身影响很大(使得命题3不成立),另一个是状态方向和nuisance方向混合(不像命题3一样简化了bad view中的数据增强)
Theorem 4
设从现实数据分布 推导得到的世界核(令x的表示只取决于z)为 ,对于真实数据分布和世界核我们可以分别得到优化的最优解,假设世界方向要比nuisance方向更强,那么我们有这两种最优表示的区别为
其中
这里的描述混合作用,具体是什么可能不太重要
那么两个模态的转换就有
也就是说,真实数据下,两个模态表示的转换存在一个误差的上界,这个上界由世界方向和nuisance方向的混合程度限制
这个混合是由数据增强导致的,也就是至少要有bad view的参与,对于good view设置下,误差为0,无论是d还是都是0
定理实际上给出了误差的上下界
NTP is a Bad-View JEPA
Proposition 4
NTP可以被写成JEPA形式
第一项是预测项,第二项是约束项,也就是第一项是正确的token预测的内积,第二项是softmax的分母,这里context c和y作为正样本对,存在最优解满足 ,最优解之间可以通过一般线性群 (所有可逆的kxk实矩阵)转换。同时NTP的数据形式是bad view
基本解释如下
分母要求每个context对应不同的embedding,因为如果都一致没有任何分数差异,所以可以防止坍塌
NTP的损失是
最优时
此时可以得到
bad view是指,context c和target y,本身是同一个document的不同corrupt,同时这样的训练目标引入了更强的混合作用,本身document的风格会帮助模型学习下一个词,这个帮助只在当前的document有效(如果good view,那么两个文档的风格彼此没有什么关系)
那真的没有good view吗,这里补充了一个称为隐式正样本的内容,不同的文档可能存在相同的y,会通过weak的一个token建立联系,论文认为这样的联系很弱
Summary
在进入实验之前,简单梳理一下
- 定理1给出了两个模态正样本分布相同时,得到相同的表示的条件(PRH的直接定理化)
- 命题1给出了定理1约束下的最优解
- 定理2放宽条件,不要求正样本分布相同的误差上界,到这里证明了PRH成立,有解,模态间存在对齐变换
- 命题2则讨论了怎么得到这个对齐变换
- 定理3进一步扩展约束,引入干扰因素nuisance,讨论对齐付出的代价
- 命题3对比good view和bad view的优劣:因为nuisance在good view上彼此无关,所以good view能够更容易得到更好的世界状态编码,也更容易对齐
- 定理4将讨论放宽到真实数据
- 命题4则说明NTP也可以是JEPA,同时是bad view JEPA
Experiments
Good Views Help Alignment
good view真的比bad view更好吗
Setup
- baseline
- LeJEPA
- BERT
- NTP version
- NTP pairs,append另一个相同图像的caption
- masked spans(bad view JEPA) — 8个不同views of one caption
- caption views(good view JEPA) — 8个同一张图像的不同caption
- data
- Flickr30k Karpathy split
- Metric
- Mutual 10-NN 10个近邻是否重合
- image-caption retrieval
- 拟合一个正交变换(正交约束的线性层,这里不需要训练,可以直接通过SVD分解来得到),
- R@1
- R@5
图像编码器是LeJEPA,按照划分属于bad view
文本编码器分成了good view和bad view,值得注意的是
文本编码器使用了LeJEPA损失,masking的方式是一样的,从caption中截取一段,全局视图保留50%-100%,局部保留15-50%,只有数据来源不同
这实际上是有点奇怪的:
- good view使用了多k倍的数据
- good view进行caption的截取,这样的截取mask掉了世界状态的一部分,怎么说呢,只能说有很多和理论没有什么关系的trick
Good Views Align Across Modalities
直接看性能的话
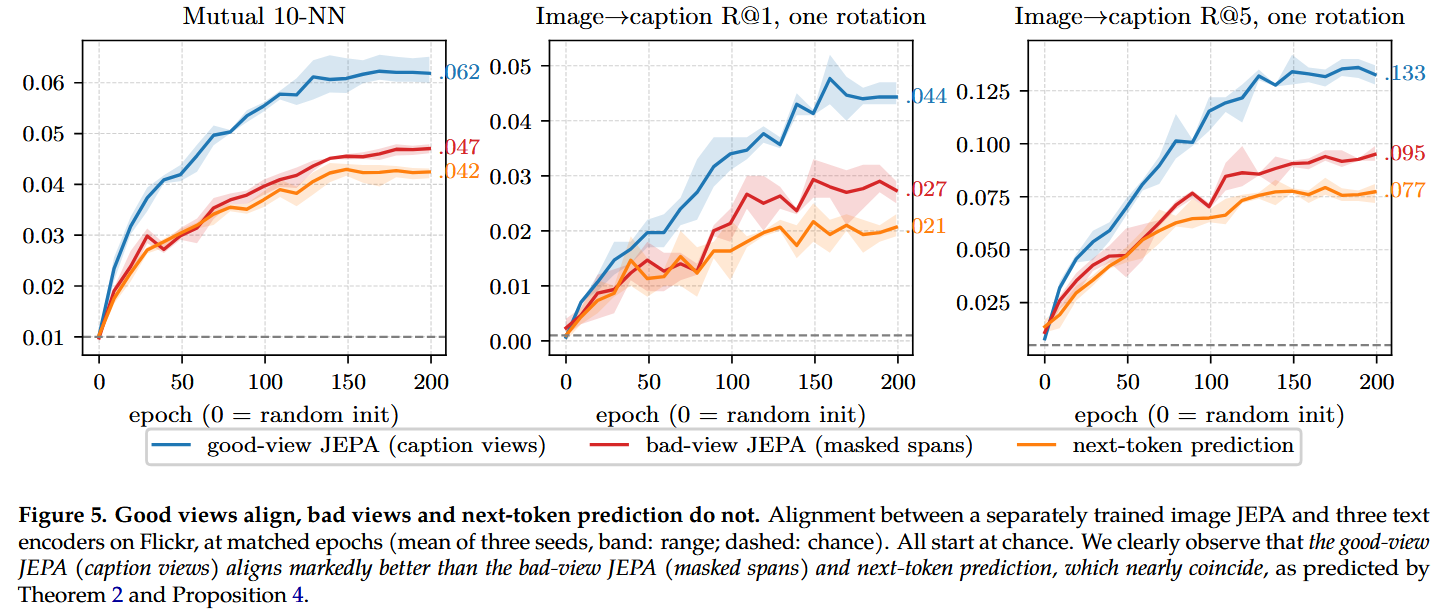
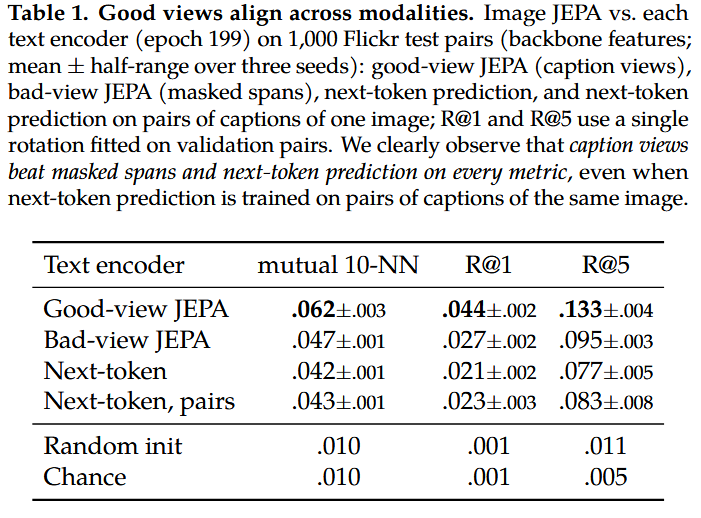
NTP的损失结果是最差的,这里的实验good view比bad view多看到了约4倍数据
除了性能之外,论文做了两个其他实验
图文对齐分布在哪些方向?good view是否保留了更少的nuisance信息
这里进行了主成分分析,发现对齐主要发生在前面的维度上
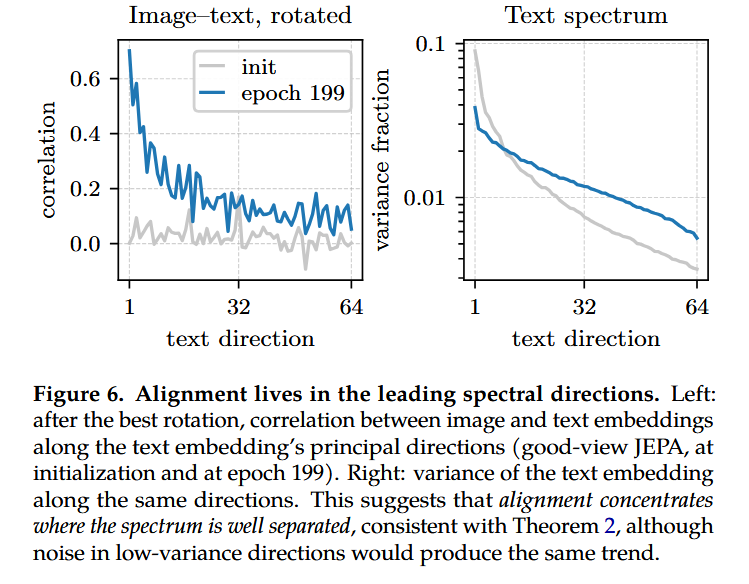
定理3给出了nuisance误差下界和评估nuisance的方式,得到的结果也符合理论
| 文本编码器, | 场景解释指标 ↑ | 定理 3 给出的误差下界 | 实测最佳旋转均方误差 ↓ |
|---|---|---|---|
| Good-view JEPA | 0.804 | 12.6 | 33.5 |
| Bad-view JEPA | 0.655 | 22.1 | 39.4 |
| NTP | 0.608 | 25.1 | 40.3 |
Trimming Makes Good Views, the Rest Barely Matters
哪部分对good view更重要
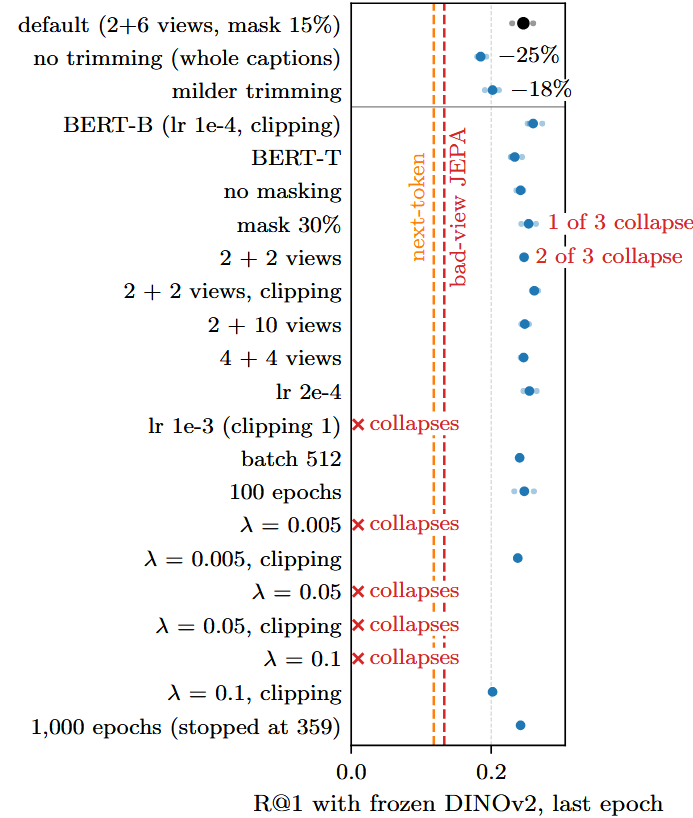
消融发现截取是最重要的,不做mask有影响但是不大,这里一定程度回答前面setup的问题
Good views Help both
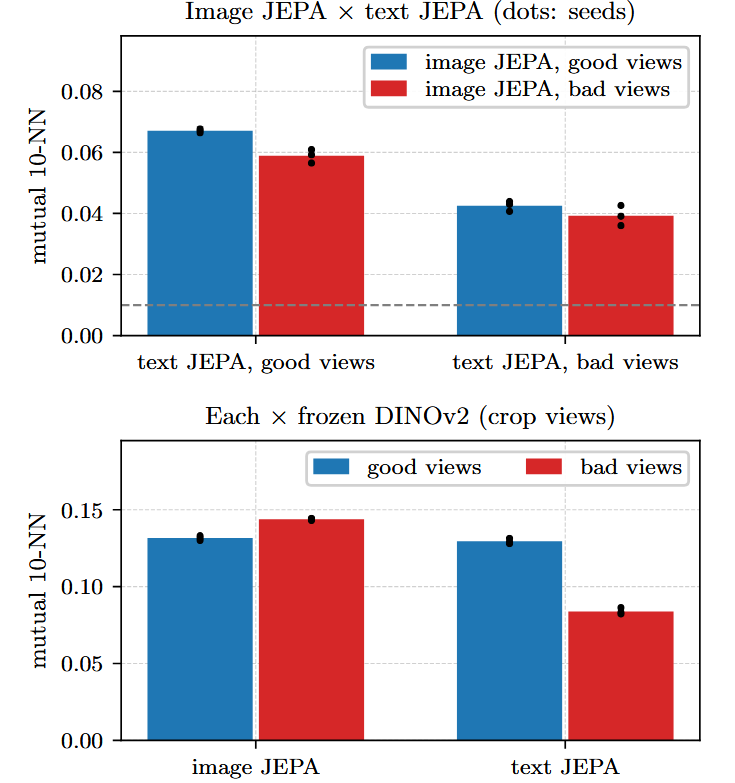 通过视频训练了图像侧的good view,然后通过计算性能
- 上图横轴是不同的text JEPA,不同颜色是不同的image JEPA
- 下图和DINO计算相似度
这里DINO的image JEPA good view不如bad view,论文认为是DINO的训练方式和bad view是一致的,所以会更接近,其他的都是good view领先
Good View JEPAs Beat Pretrained LM
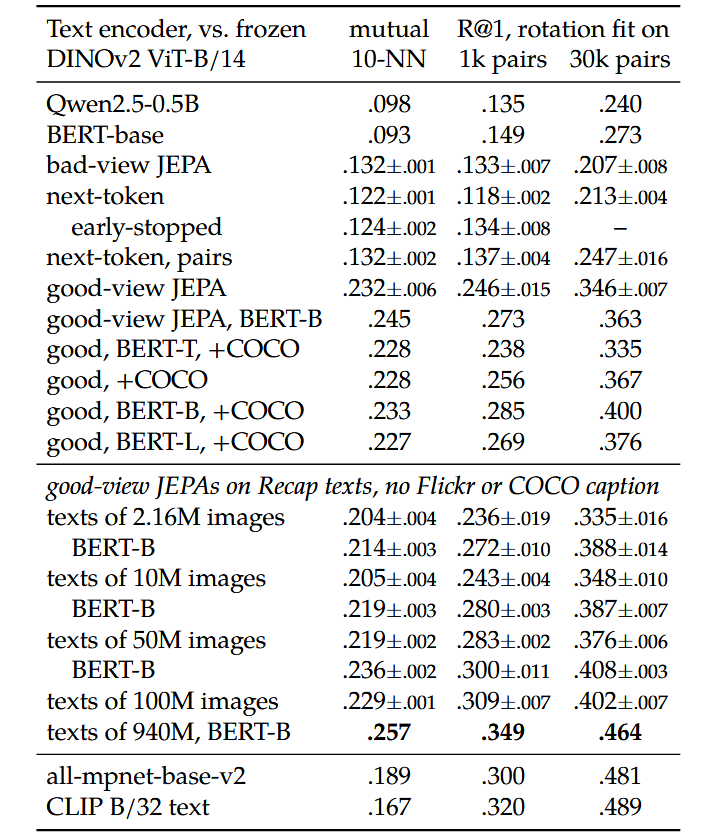
这里和预训练的LM和text encoder进行对比,主要是训练规模存在较大区别,固定图像侧为DINOv2
- 单纯看mutual 10-NN可能不充分,可能本身结构会有相似的地方
- 三个指标综合起来看,texts of 940M BERT-B 可以和pretrained text encoder对比
- 这个规模是相当的,这里good view并没有超出他们的性能
- 这里不好说,不是公平的对比,只能说定性比较,CLIP本身是图文对训练的,要得到一个rotation可能更容易,MPNet训练数据有测试数据
NTP Scales Poorly
NTP真的很烂吗
Good Views Scale on Web Text
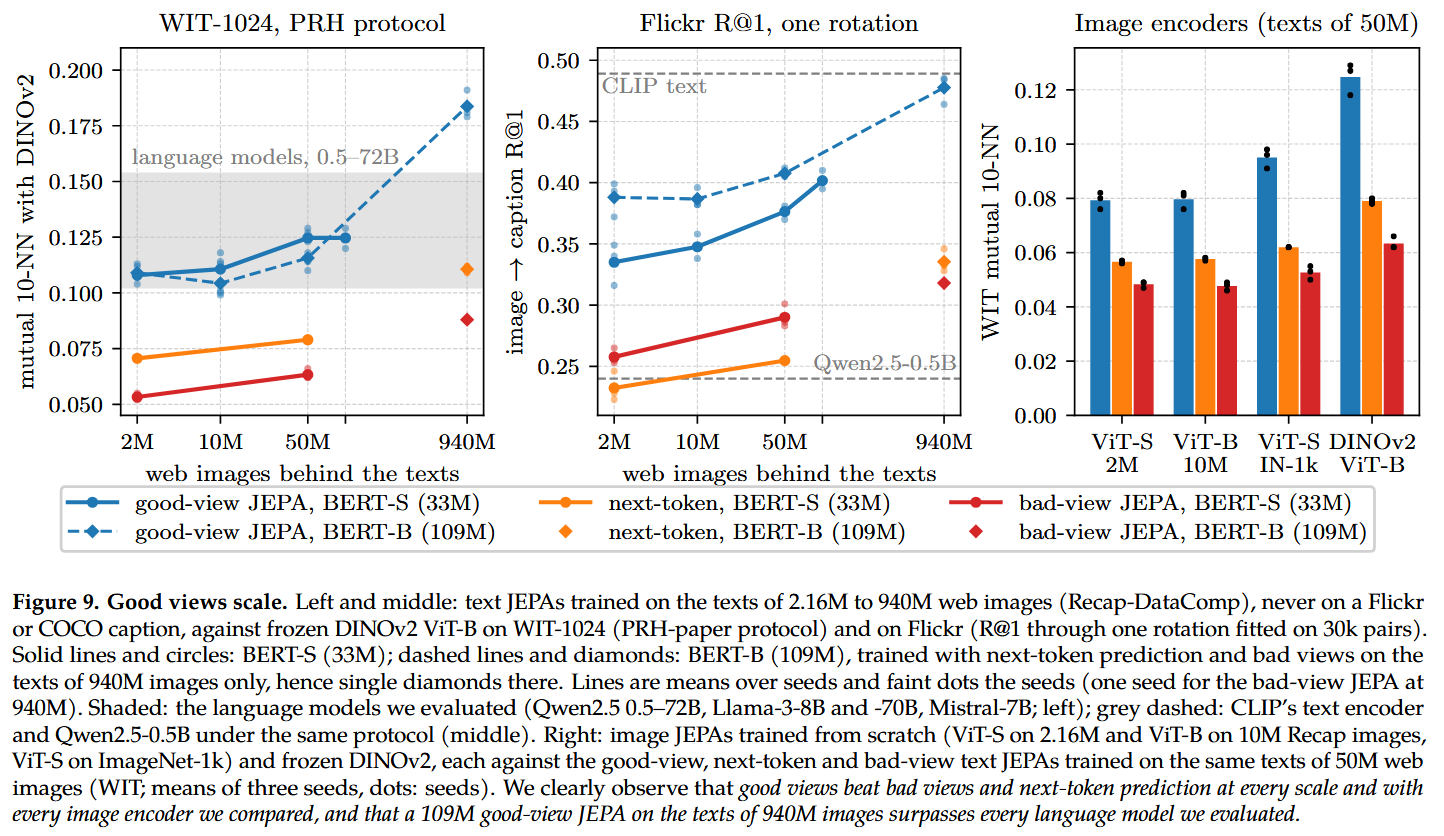
首先这里想看的是scale Web text之后性能的变化,在WIT上的近邻性能,good view 50M的水平,说和Qwen2.5-4B, 7B接近(超过),这里的接近是指固定DINOv2,然后做近邻判断,也就是可能表征的结构上比较接近
如果看retrieval的话,scale的曲线和近邻不同,有更明显的scale表现
柱状图是固定text encoder规模(50M),改不同的训练方式,更改image encoder进行的对比,good view领先,随着规模提升有一点提升
这里的模型都没有在WIT和Flickr上训练过,只使用了Web text 实际上table 2已经展示了scale的表现,这里是回到了PRH的bench上再做一次
Good Views Need 42 Times Fewer Samples
相同规模的text encoder,在相同的训练设置下(不一定对谁最优),good view 21.4M samples(2.16M图像的文本) 和 NTP 900M samples(940M 图像的文本)表现相近,good view需要的数据量比NTP少了42倍,token数量少了14倍,图像数量少了 435倍
A 109M Text JEPA Beats Language Models up to 72B Parameters
考虑fig 9的左图,最大规模的good view text JEPA
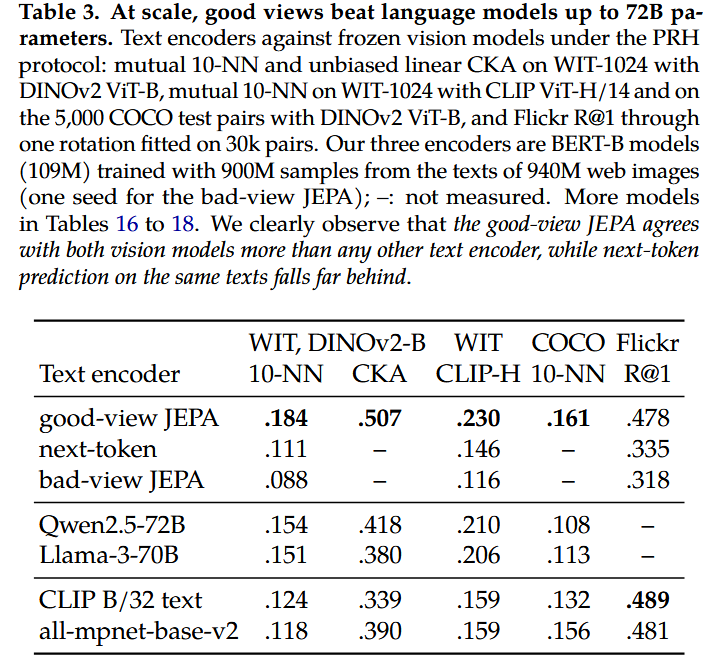
- 表现超过了所有论文测试的LM,包括Qwen2.5 0.5B - 72B, Llama 3 8B - 70B, Mistral 7B,这个表现在所有尺寸的DINO上都保持
- 只考虑前三行的话,收益来自于good view
- 换成CLIP,MAE,I-JEPA作为固定的视觉模型,good view都领先
- 检索上(最后一列)和CLIP相近
到这里都是text encoder good view的表现,这是一个证据很强的实验,good view text JEPA参数量和数据量远小于LLM(参数量1:600),在对齐上能够超过它们,同时和图文对齐训练的CLIP comparable,只要能复现确实很有东西
Scaling Law for the PRH
也就是对齐的scaling law,不过看起来规模很小,可能只是toy
根据经验给出公式形状,公式中前两项可以理解为只用bad views的收益,描述bad view下数据量增加的变化,第三项描述good view的收益 纯bad view决定了基本斜率和截距,good view的增益体现在斜率
进行45次训练,拟合到这些参数值
| 参数 | v2 拟合值(约) | 在公式中的作用 |
|---|---|---|
| 0.171 | bad-view 基线的截距。其数值取决于 的计量单位。 | |
| 0.0289 | 控制 bad-view 基线随 的增长。 | |
| 0.0307 | 控制 good-view 增益对最终 R@1 的贡献幅度。 | |
| 0.244 | 调节对数内部 的尺度。 | |
| 1.068 | 描述增益对 good-view 比例 的敏感程度。 | |
| 0.317 | 描述增益随累计训练项数 的变化。 同时也出现在基线项中。 | |
| 0.193 | 描述在给定 时,增益随数据池大小 的变化。 |
R@1使用检索的指标,M是训练数据量(samples),N决定数据池(images的数量),q是使用good views的比例
有图像
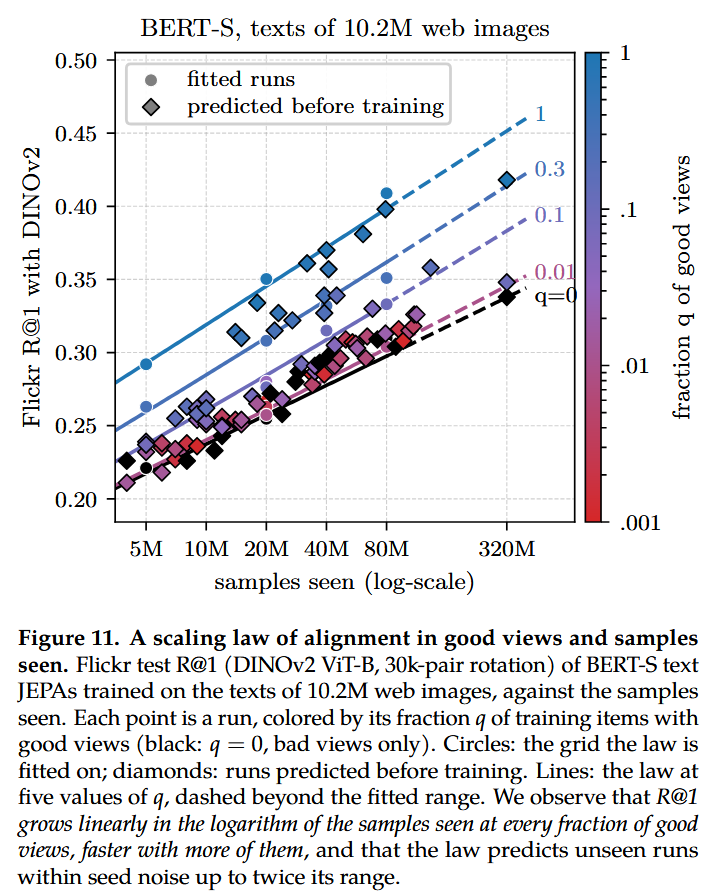 固定 BERT-S,改变三个变量得到不同的直线,菱形是预测值,圆形是实际值
预测表现
| 320M 时的 (q) | 公式预测 R@1 | 实测 R@1 |
|---|---|---|
| (0),全 bad views | 0.337 | 0.338 |
| (0.1) | 0.389 | 0.348 |
| (1),全 good views | 0.455 | 0.418 |
Platonic Representations as a Tool
PRH有什么用
Captioning without Training
这里的without traninig指的是不需要特别训练caption,只需要训练rotation
具体而言,需要训练一个decoder,这个decoder接收good view text JEPA,还原caption,然后caption的时候,训练rotation,将DINOv2的embedding进行旋转之后作为输入,要求输出caption
训练的时候需要加高斯噪声,用于减缓对齐误差的影响
这里有一个计算噪声强度的做法,属于实现细节,详见论文
实验结果很多,基本指标是CIDEr,判断生成caption和多个GT的重合程度,大概有以下实验
- 按照实验设置进行caption的实验,使用在Flickr上训练的文本编码器和解码器,是一共1014对图文对训练rotation,然后在Flickr上测试caption,CIDEr达到 0.396,如果是直接重建 CIDEr是0.628,随机旋转是 0.043
- 探究如果没有足够的图文对来拟合rotation,如何得到rotation,这里先用30对进行拟合,然后用启发式的方法根据图文对嵌入的的匹配结果更新旋转,结果为 0.169
- 能不能把在一个数据集上拟合的旋转用于另一个数据集做caption?在Flickr和COCO上训练的encoder和decoder,在30k Flickr上拟合旋转,在COCO中caption,结果是0.668,随机为 0.038
- 使用预训练Qwen2.5-1.5B加强decoder,更强的encoder,更强的图像编码器,希望看一下性能能够提高到什么程度,同时看一下旋转的约束(正交)是否重要
- 性能可以达到 Flickr 0.519, COCO 0.838
- 一组映射对比为
- 旋转的表现Flickr 0.504, COCO 0.802
- 线性映射 0.531, 0.635
- MLP 0.498, 0.585
- 能不能用在图片上拟合的captioner来描述视频,发现还是可以的,结果为 0.246
Alignment Without Any Pair
如果完全不存在配对,如何进行对齐
这里通过两个编码器embedding相似度匹配的方式来得到初始的旋转,然后不断迭代,比较复杂/fancy
这里比起实验,更有意思的应该是 这里完全不存在真正可以匹配的图文对,要找到图文旋转矩阵,只能研究embedding内部的关系。在聚类后,图像簇和其余图像簇的相似度,应该和它对应的文本簇到对应的文本簇相似度接近。可以假设,或者说大概率聚类之后,虽然我们找不到真正对应的图文对,但是这些簇汇聚了整体的信息,簇之间的关系可能可以在跨模态也有体现,依据这个假设就可以找到粗糙的图文配对
Conclusion
看完?后的想法很复杂,比起很受启发,主要还是看不懂和深感自己的知识匮乏
这篇工作是我看过的所有工作中信息量最密集的(一段话的实验量堪比WAM的整篇论文),密集到我无法在没有附录和AI完全辅助下跟上论文的内容,以至于通篇读下来无比痛苦,同时对很多内容到目前也不是特别理解,直接治好/加剧了我的脑腐状态。
回归论文的话,PRH是一个有趣的假说,虽然原文暂时没有读过,但是将哲学理论引入DL又特别合理这件事情确实很有意思。柏拉图认为存在一个理想的世界,用洞穴寓言表达人们被理想的投影欺骗,无知地度过一生。在表征这里,所有的世界观测(按照假说)对应一个唯一(或者旋转意义上唯一)的世界状态/表征,当前这篇论文从JEPA的角度论证了这件事情,以我的学识,目前还意识不到这是不是一件颠覆性/阶段性的事情,但是存在统一的表征这件事情本身就足以令人振奋(Unified确实是可以存在的,几百年的世界语言难道可以通过AI实现吗)
论文的大多数证明,虽然我看不懂,但是还是有很强的假设的,同时LeCun自己的LeJEPA/SIGReg没有被证明符合论文给出的前提。要用数学来论证现代模型的合法性还是太超标了,大量的数学究竟是让DL更难了,还是更简单了呢
为了假装自己读懂了一些内容,这里简单展开几个胡思乱想
- 首先是good view和bad view,这是我读这篇论文最关注的地方,PRH成立是符合直觉的,问题在于怎么做可以高效地得到世界表征。good view依赖于同一世界状态的不同观测,本身就要求更多的数据/信息,也更难得到(除了文本),而bad view实际上对应了绝大多数SSL正在做的事情:希望一份数据可以自己给自己做监督
- 所以good view效果好同样符合直觉,问题在于good view要怎么得到足以scale的数据,即使论文证明了 good view JEPA比NTP高效42倍,如果数据规模scaling的难度43倍难于bad view,那也没有价值,所以NTP目前来说,即使论文实验在大规模下成立,也没有被替代
- 另一个是,这里不同模态只讨论了图像和文本
- 那么不同的VFM是否也是不同的模态呢,不同的LLM是否也是不同的模态呢
- 这是否给REPA系列工作一个新的解释,表征注入实际上是提供了一个新的view,除了表征本身的信息增益之外,这样的训练范式本身也带来了增益
- 那我mHC + multi REPA是否意味着有效()
- 再一个是,NTP这里的损失讨论是在loss层面
- 本身attention,linear attention,TTT也是一个bad view的过程?
- 同一个输入x,QKV不同的transform/corruption,要求建立QKV之间的关联,按照TTT或者linear attention来理解,k和v之间构成了自监督的损失,这个损失的形式就是bad view的形式
- 那么good view的设计能否用于优化attention,或者简单一点,用于优化 TTT 呢
- 另外的就是对于image encoder,前面的实验里,使用视频数据训练得到的结果,文本侧的提升更明显,可能和数据有关,文本要获得good view很容易,但是图像就比较困难了
- 也就是说现在多模态依旧是路边吗
如果社区对这篇论文的反响不错,或者JEPA系列拥护者给出了核弹结果,那么我将回来加深这篇论文的理解(大概)